스캔 교재와 무자막 강의를 출처까지 찾는 검색 도구
스캔 교재와 무자막 강의를 출처까지 찾아 주는 검색
검색 안 되는 스캔본과 무자막 강의
다뤄야 할 수업 자료는 두 갈래입니다. 하나는 스캔해서 글자를 검색할 수 없는 PDF 교재, 다른 하나는 자막이 없는 영어 강의 영상이었어요.
요구는 네 가지로 정리됐습니다. 지정된 이메일 도메인 계정만 들어올 것, 교수가 배포한 과목 자료와 학생이 올린 개인 자료가 섞이지 않을 것, LLM 답변에는 반드시 페이지나 타임스탬프 출처가 붙을 것, 그리고 상시 켜 두는 서버 없이 굴러갈 것. 마지막 조건이 사실상 스택을 결정했습니다.
서버 없이 돌리는 인덱싱과 챗
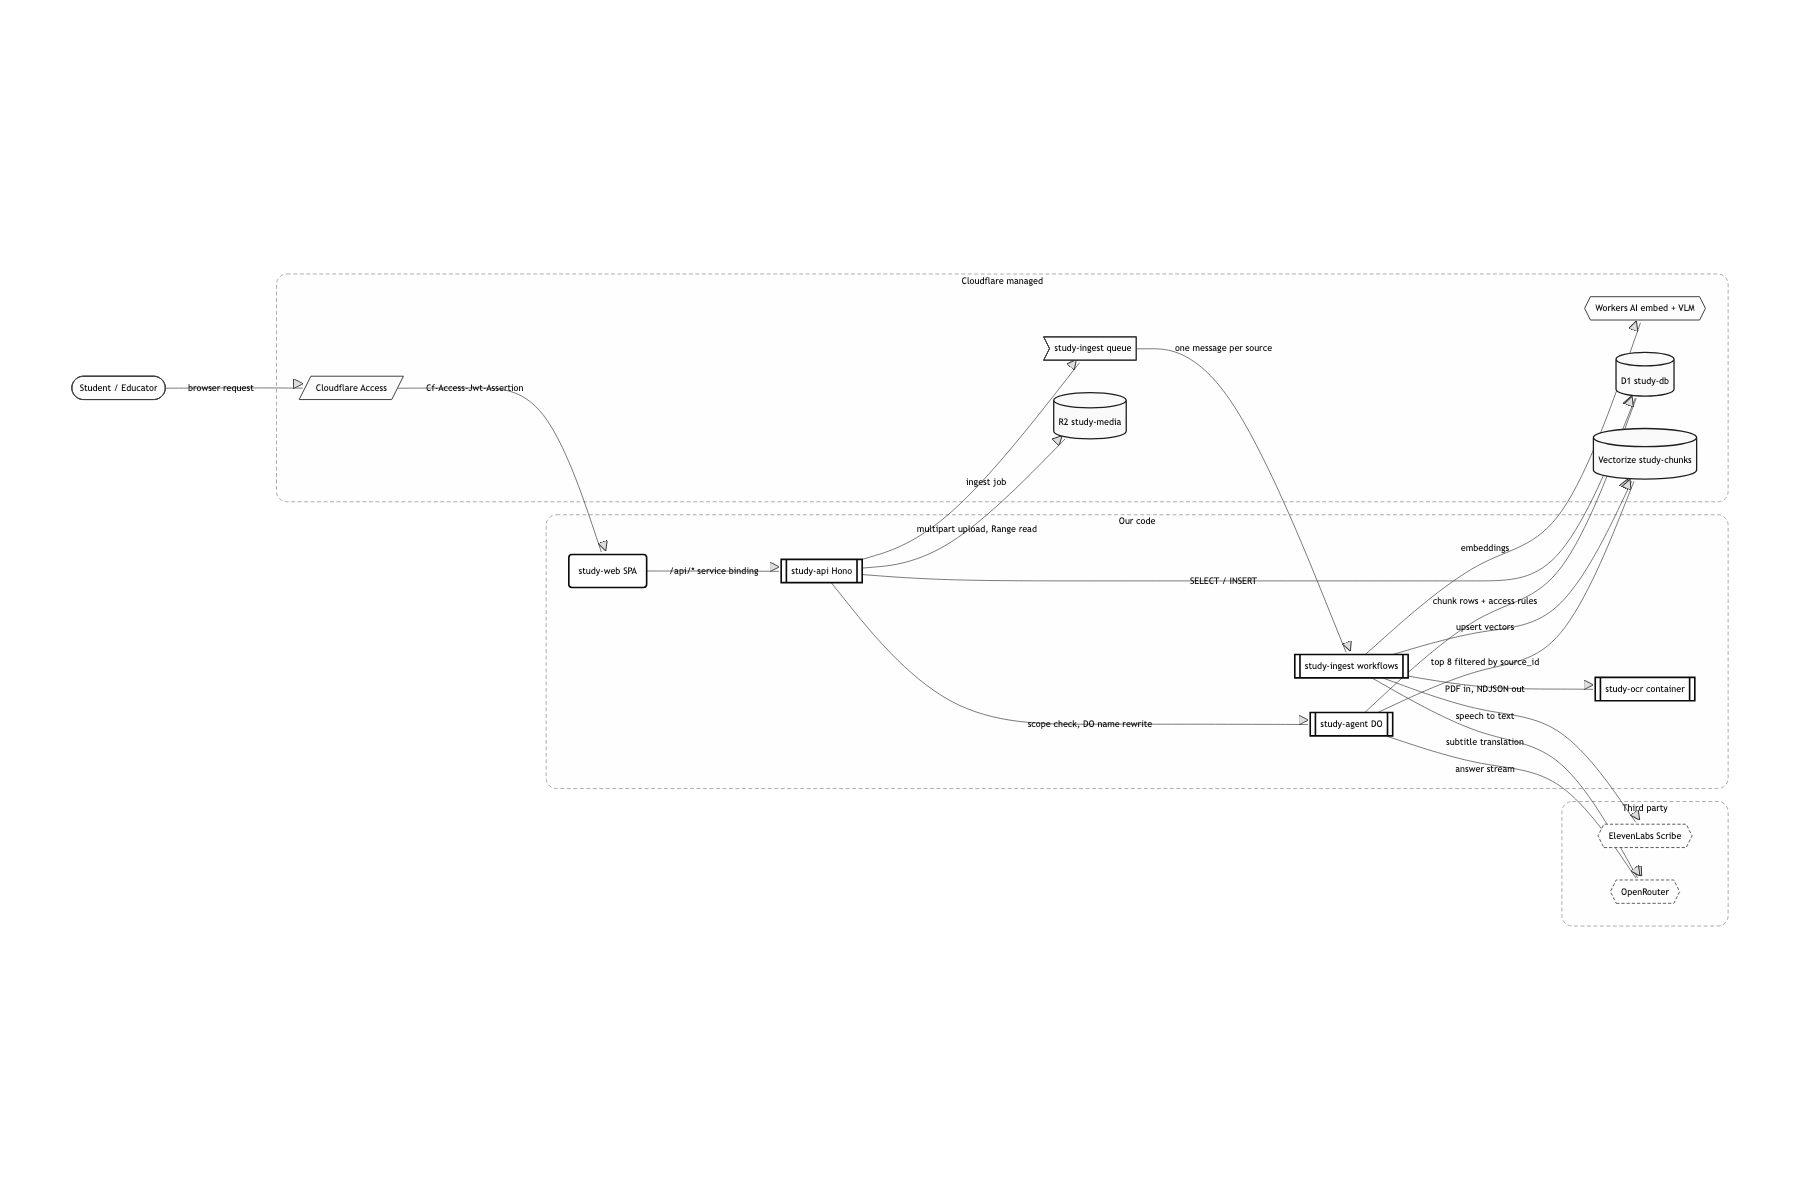
Cloudflare 한 계정 안에서 끝내는 구성: Workers, D1, R2, Queues, Workflows, Vectorize, Workers AI, Containers
상시 서버를 살 수 없었고, 인증·스토리지·큐·벡터 검색이 전부 바인딩으로 붙으면 붙일 인프라 코드가 거의 없어집니다. 워커끼리는 서비스 바인딩으로 부르니 내부 통신에 공개 엔드포인트를 만들 필요도 없었어요. OCR 컨테이너(study-ocr)는 Workers Paid 플랜이 있어야 이미지를 올릴 수 있고, Worker 메모리는 128MB로 묶여 있습니다.
로그인을 앱이 아니라 Cloudflare Access에 맡기고, 앱은 JWT 검증만 한다
허용할 이메일 도메인 Allow 정책 한 줄이면 접근 통제가 끝납니다. apps/api/src/auth.ts는 Cf-Access-Jwt-Assertion을 JWKS(10분 캐시)로 검증하고 email 클레임으로 사용자를 찾거나 학생으로 자동 생성해요. 비밀번호도, 세션 테이블도 만들지 않았습니다. 로컬에서는 Access를 흉내 낼 수 없어서 AUTH_DEV_BYPASS=1 + study_dev_user 쿠키로 시드 계정을 갈아 끼웁니다.
인덱싱은 요청 밖으로 빼서 Queue 한 건 + Workflows 여러 step으로
OCR은 90분, 자막 번역은 60분까지 잡아 둔 작업입니다. 요청-응답 수명 안에서 돌 수 없어요. Workflows의 step 단위로 타임아웃과 재시도를 따로 걸고, 이미 만들어 둔 cues-en.json이 있으면 STT를 건너뛰고 번역만 다시 돌립니다. 라이브 큐 컨슈머는 하나여야 해서 PR 프리뷰에는 study-ingest를 올리지 않습니다.
채팅은 Agents SDK Durable Object로, (사용자, 스코프) 조합마다 인스턴스 하나
대화 이력을 DO 상태로 두면 세션 테이블이 필요 없고, WebSocket으로 status → context → delta → answer를 그대로 흘려보낼 수 있습니다. 자료 화면, 과목, 노트북, 전체가 각각 다른 방이 되죠. DO 이름이 곧 격리 경계라서, 이름을 클라이언트가 정하게 두면 그 순간 남의 방에 들어갈 수 있습니다.
임베딩은 Workers AI의 EmbeddingGemma, 답변 생성은 OpenRouter
임베딩은 인덱싱 때 수천 번 부르니 계정 안에서 돌아야 싸고 빠릅니다. 반대로 답변 모델은 자주 갈아 끼우고 싶었고, 채팅 입력창에서 모델 문자열을 바꿔 볼 수 있게 열어 뒀어요. 키가 없는 로컬에서는 검색 결과를 요약한 모의 응답을 같은 프로토콜로 스트리밍하고, Vectorize를 못 쓰면 D1 키워드 검색으로 내려갑니다.
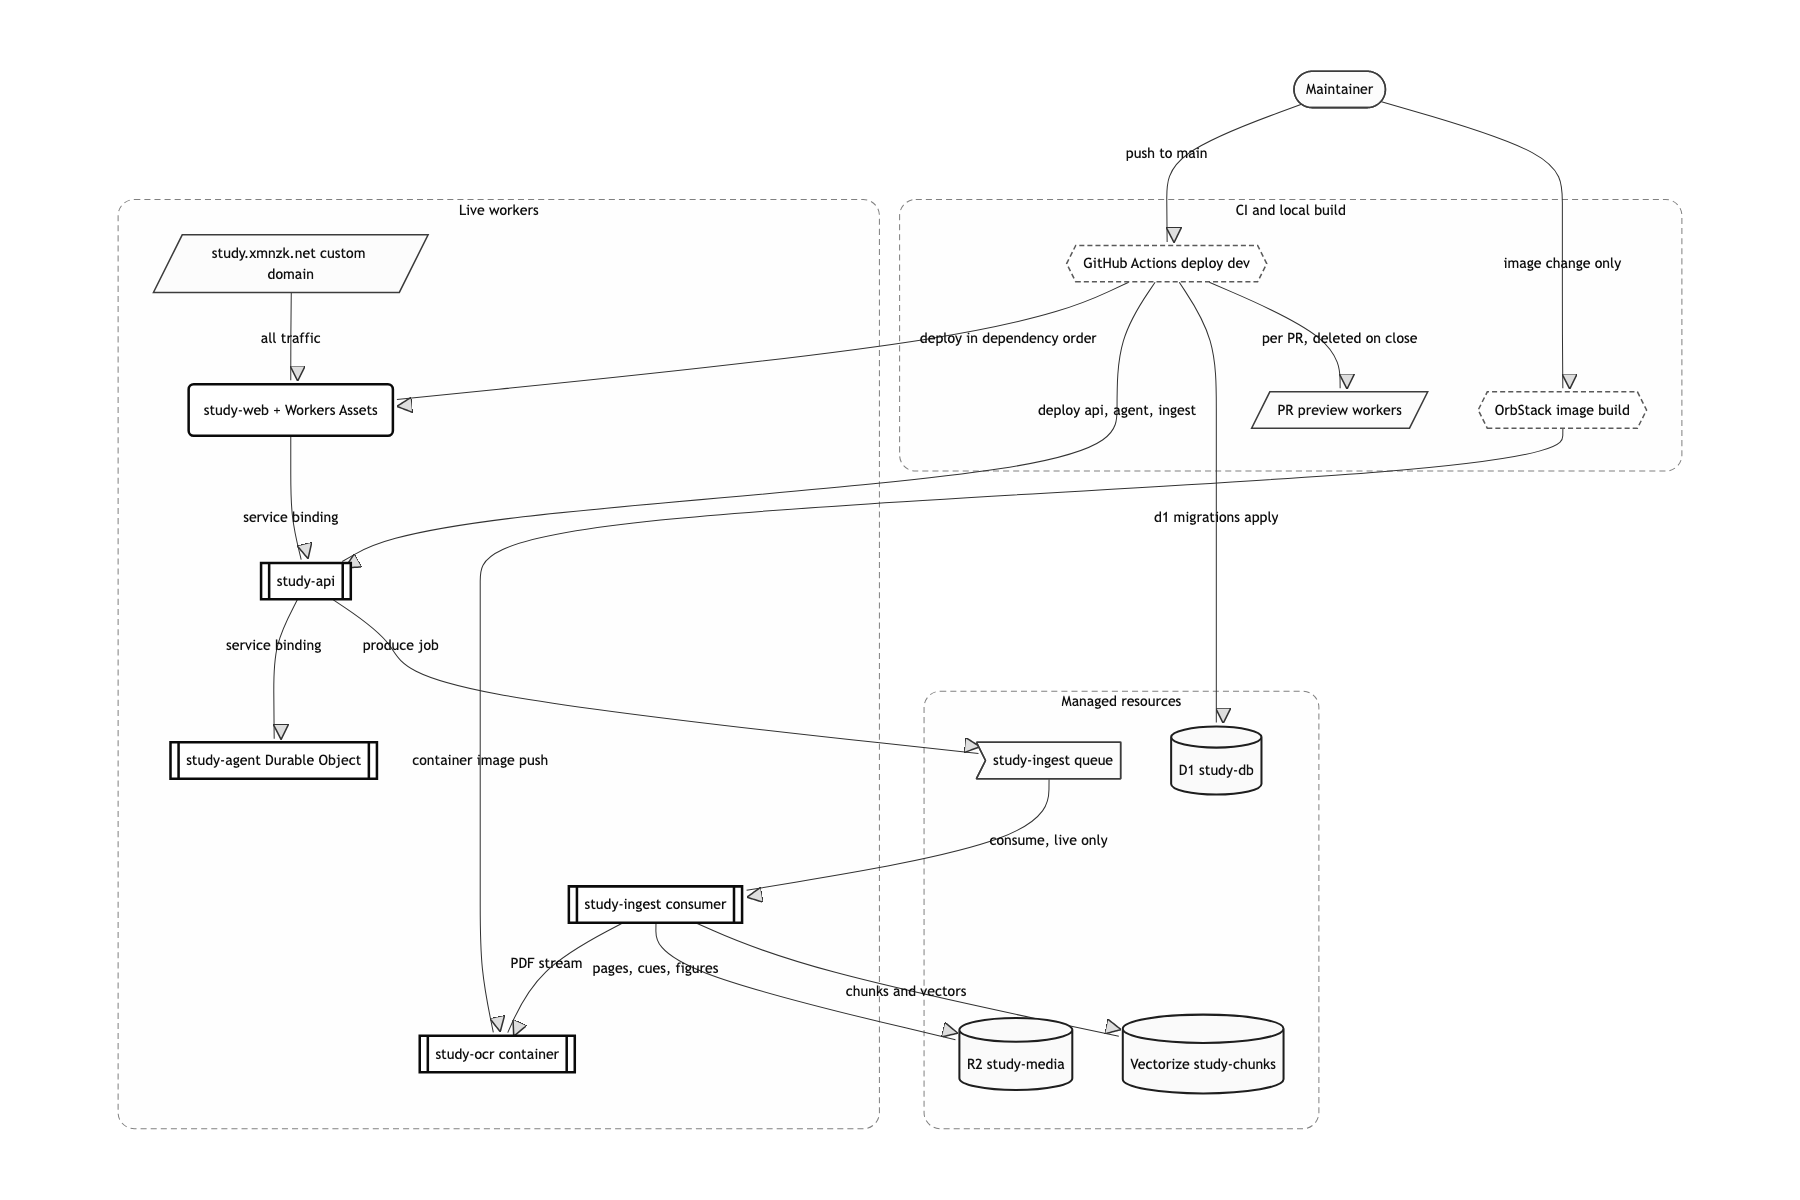
API와 챗이 공유하는 권한 규칙 한 벌
앞단은 study-web 하나입니다. Workers Assets가 SPA를 내보내고, /api/*만 워커가 먼저 받아 study-api로 서비스 바인딩 프록시를 합니다. 그래서 브라우저 입장에서는 정적 파일도, API도, WebSocket도 전부 같은 오리진이에요.
study-api는 Hono 하나로 CRUD(D1), R2 멀티파트 업로드, 큐 발행, FSRS 채점, 에이전트 프록시를 담당합니다. 파일은 절대 R2 링크로 넘기지 않고 API가 Range 요청을 받아 되돌려 줍니다. PDF 뷰어의 페이지 점프와 영상 탐색이 그 위에서 돌아요.
업로드가 끝나면 study-ingest 큐 메시지 한 건이 나가고, 컨슈머가 책이면 BookIngestWorkflow, 영상이면 VideoIngestWorkflow를 띄웁니다. 책은 PDF를 OCR 컨테이너로 흘려보내 NDJSON을 되받고, 영상은 ElevenLabs로 영어 자막을 뜬 뒤 한국어로 번역해 cues.json과 VTT 두 벌을 R2에 씁니다. 두 파이프라인 모두 마지막에는 청크를 임베딩해 Vectorize에, 행은 D1에 넣습니다. 진행률은 sources.ingest_stage와 ingest_progress에 계속 덮어써서 화면이 2.5초마다 폴링합니다.
질문이 들어오면 study-agent의 Durable Object가 자기 이름에서 사용자와 스코프를 되읽고, 읽을 수 있는 자료 id 목록을 만들어 Vectorize 필터에 넣은 다음 상위 8개 청크만 컨텍스트로 씁니다. 이 "읽을 수 있는가" 판단은 packages/access에 한 벌만 있고 API와 에이전트가 같은 함수를 부릅니다.
채팅방 이름을 서버가 다시 쓰게 만든 이유
브라우저가 /agents/notebook-agent/notebook-123처럼 방 이름을 정해서 붙고, 답변을 만든 뒤에 권한을 확인해 걸러 냅니다. 이러면 노트북 하나에 방이 하나라서 그 노트북을 볼 수 있는 사람들의 대화가 한 DO에 섞이고, 주소만 바꿔 치면 남의 방에 접속됩니다. 권한 검사도 API 쪽과 에이전트 쪽에 두 벌이 생겨 서서히 어긋나죠.
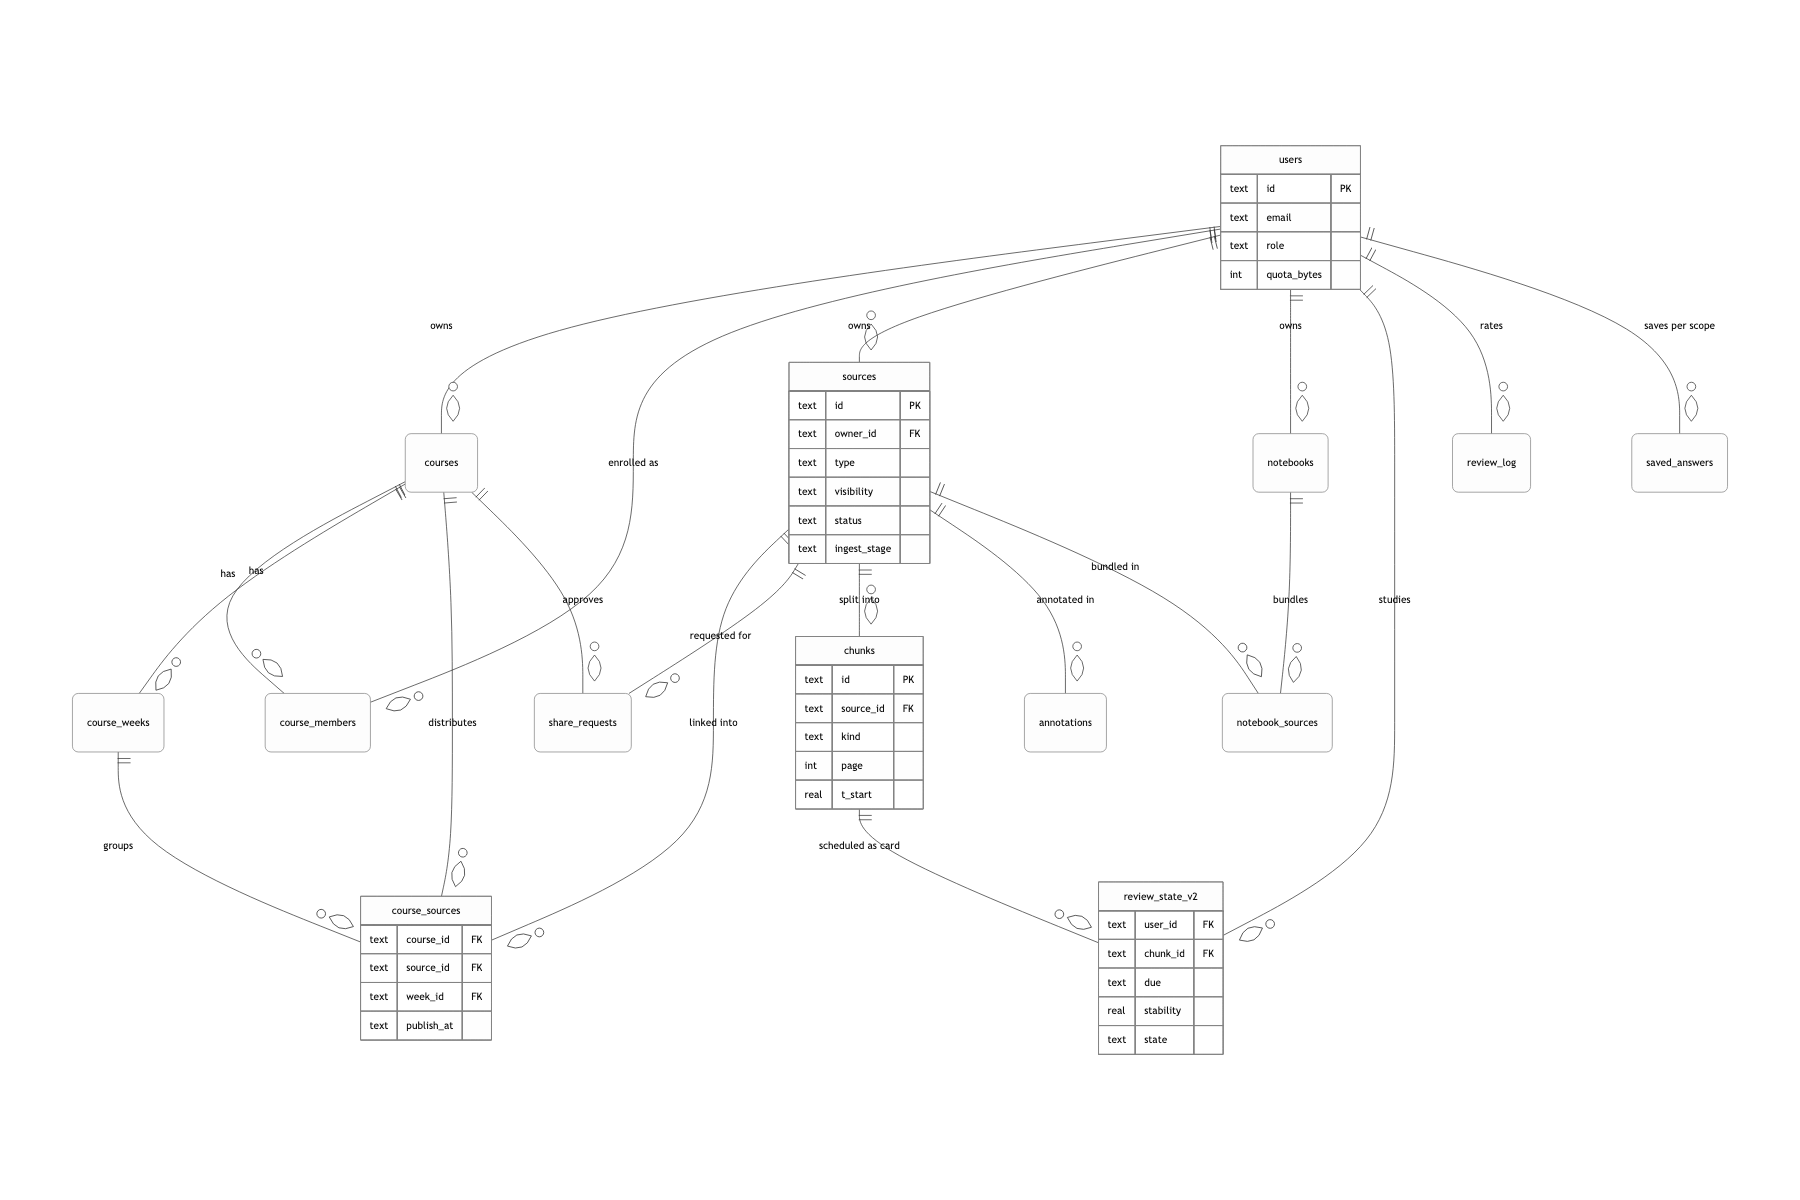
브라우저는 스코프만 말합니다(all / course:<id> / notebook:<id> / source:<id>). API 프록시가 canUseScope로 그 스코프를 쓸 자격을 확인한 다음, URL 경로에서 이름 자리만 <userId>~<scope>로 갈아 끼워 에이전트에 전달합니다. DO는 this.name을 ~로 갈라 사용자 id와 스코프를 복원하고, 검색 전에 scopeSourceIds()로 허용 목록을 만들어 Vectorize source_id $in 필터에 넣습니다. 읽기 규칙 SQL은 packages/access/index.ts의 READABLE_WHERE 한 곳뿐이고 API와 에이전트가 같이 씁니다.
세션 상태가 (사용자, 스코프) 단위로 물리적으로 갈라지니 이력이 섞일 수 없고, 사용자 id는 URL 어디에도 없으니 주소를 위조해도 자기 방으로만 돌아옵니다. 권한 판단이 한 함수라서 "API에서는 막혔는데 채팅에서는 답이 나오는" 어긋남이 구조적으로 생기지 않아요.
자막 2천 줄을 번역하면서 줄 수를 한 줄도 잃지 않기
자막 전체를 한 번에 모델에 던지거나, 반대로 한 줄씩 부릅니다. 한 번에 던지면 모델이 짧은 문장을 알아서 합치거나 쪼개서 줄 수가 어긋나고, 그 순간 타임스탬프 정렬이 통째로 밀립니다. 한 줄씩 부르면 2천 번 호출에 앞뒤 문맥이 없어 용어가 문장마다 달라져요.
20줄씩 배치로 보내되 직전 5쌍의 EN/KO를 문맥으로 같이 실었습니다. 응답은 {"ko":[...]} JSON을 강제하고, 파서가 <think> 블록·코드펜스·앞에 붙은 번호를 걷어낸 뒤 길이가 넘치면 자르고 모자라면 원문 영어로 채워 개수를 맞춥니다(parseKoList). 배치가 그래도 실패하면 절반으로 쪼개 재귀로 다시 시도하고, 모델은 Gemini 2.5 Pro → Flash → DeepSeek 순으로 물러납니다. 한 줄까지 쪼개도 실패하면 그 줄만 영어로 남기고 넘어갑니다.
어떤 경로로 실패하든 반환되는 줄 수가 입력과 같다는 불변식이 유지됩니다. 큐 개수가 보존되니 cues.json의 start/end가 그대로 살아 있고, 그 위에서 만드는 약 45초 구간 청크의 t_start도 정확합니다. 인용 칩을 눌렀을 때 영상이 실제로 그 대사 지점으로 점프하는 건 이 불변식 덕분이에요. 실패의 단위도 영상 전체가 아니라 한 줄로 좁아집니다.
유저가 할 수 있는 일
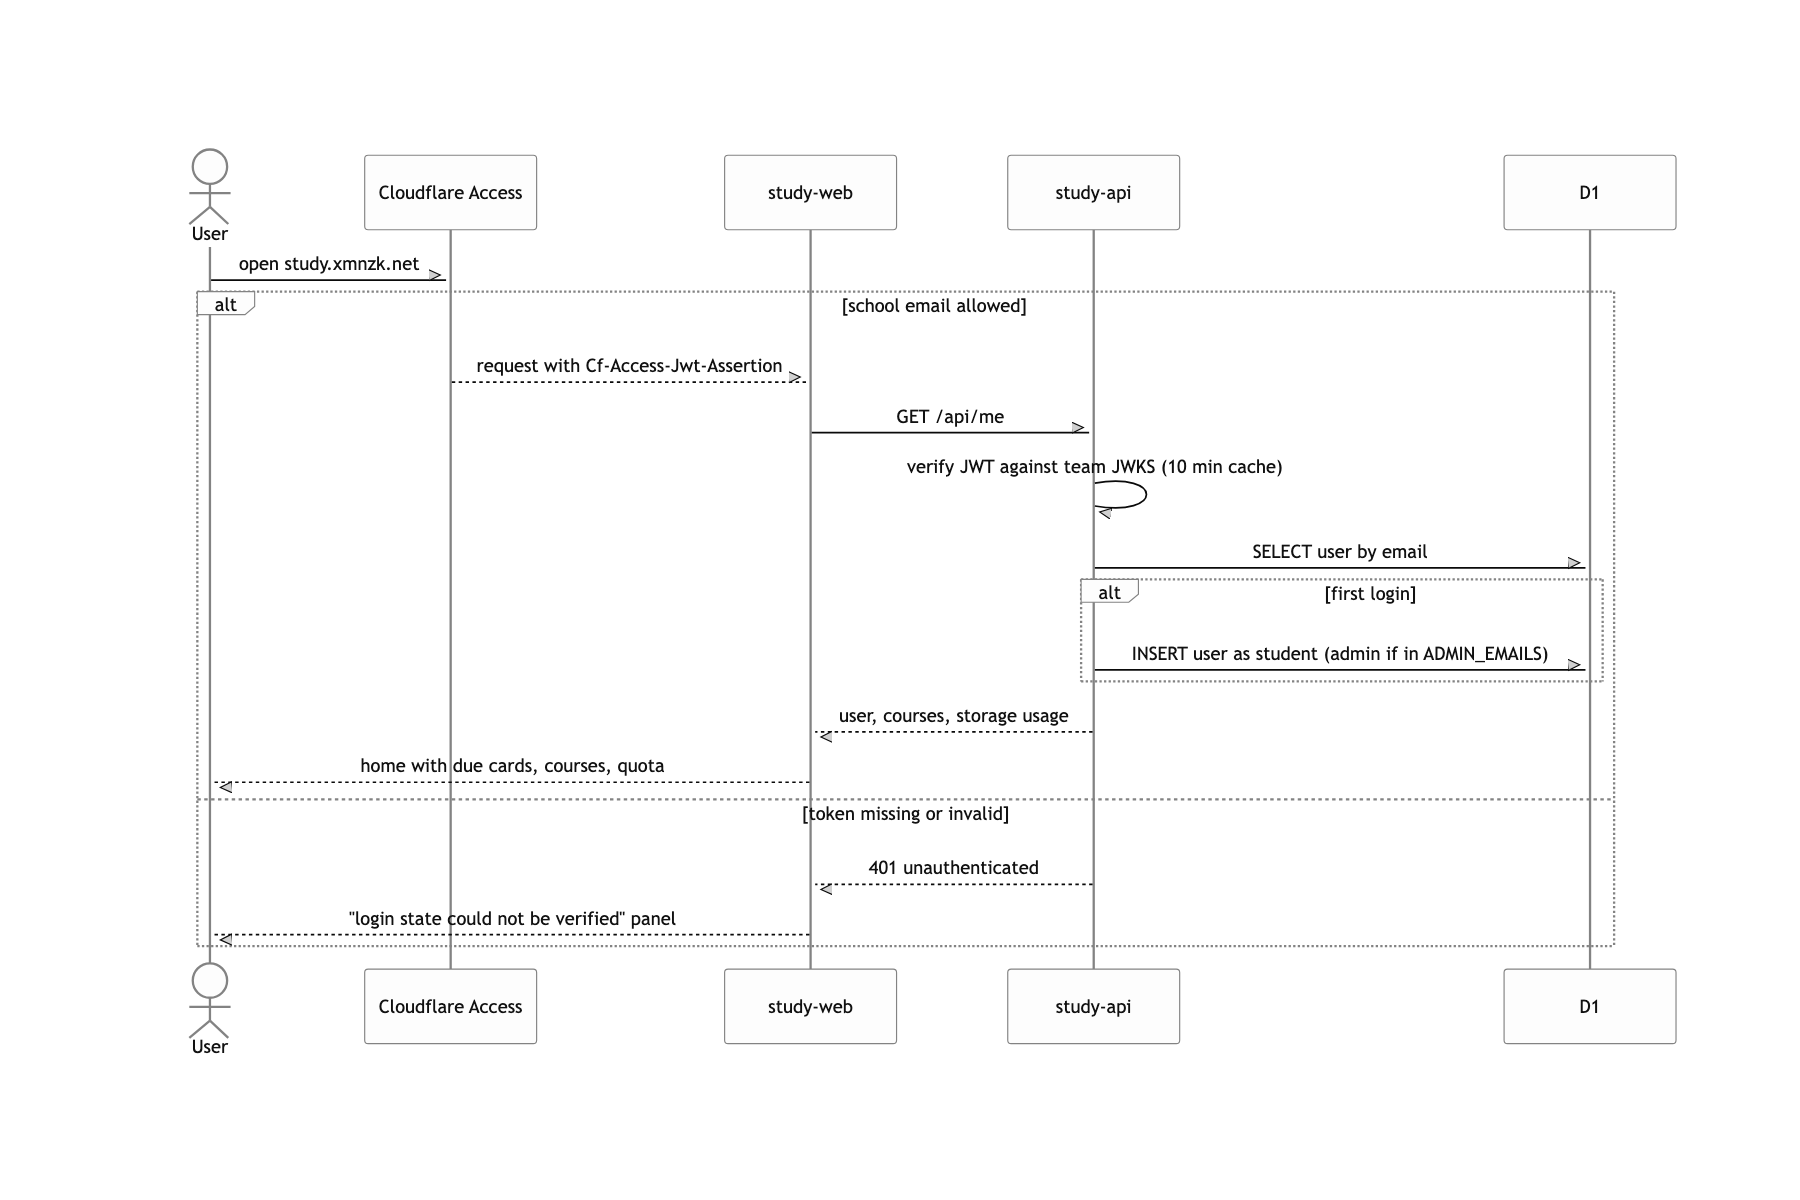
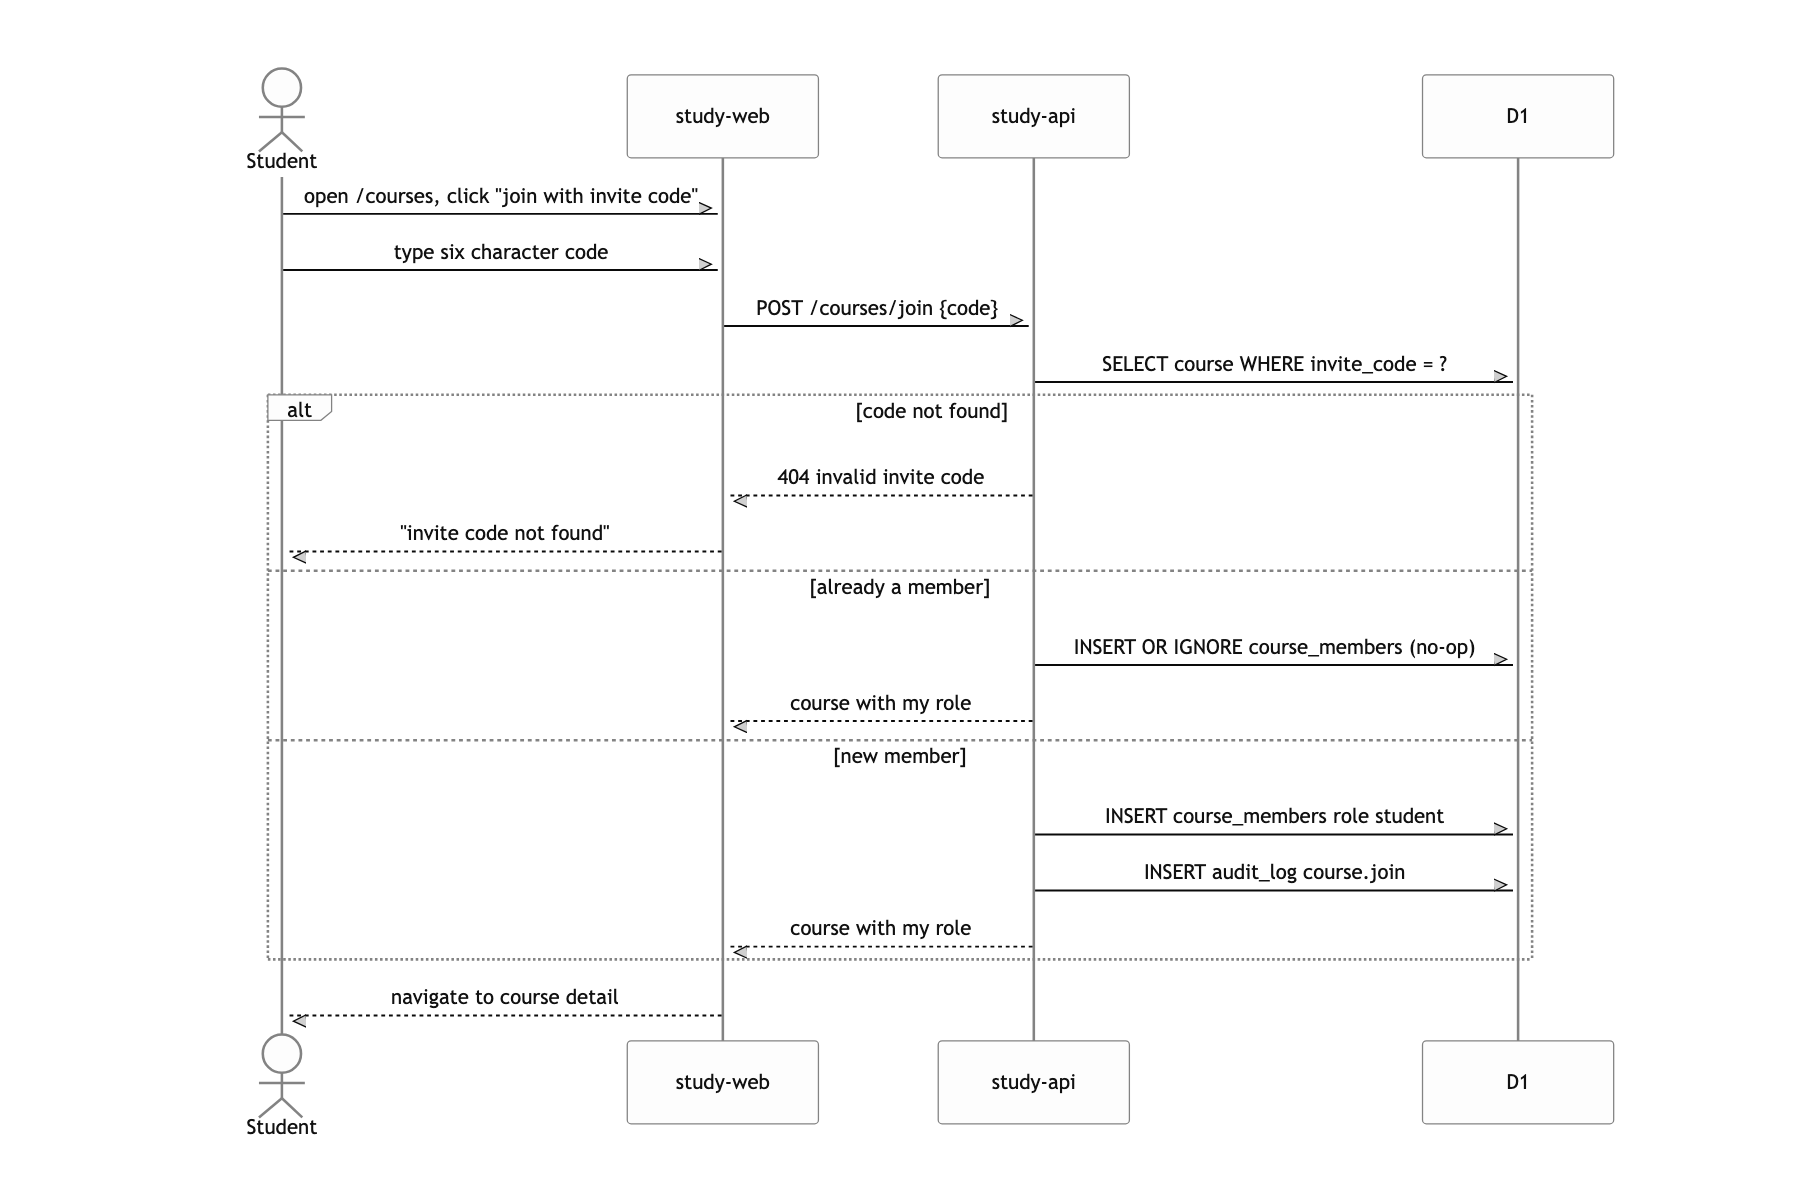
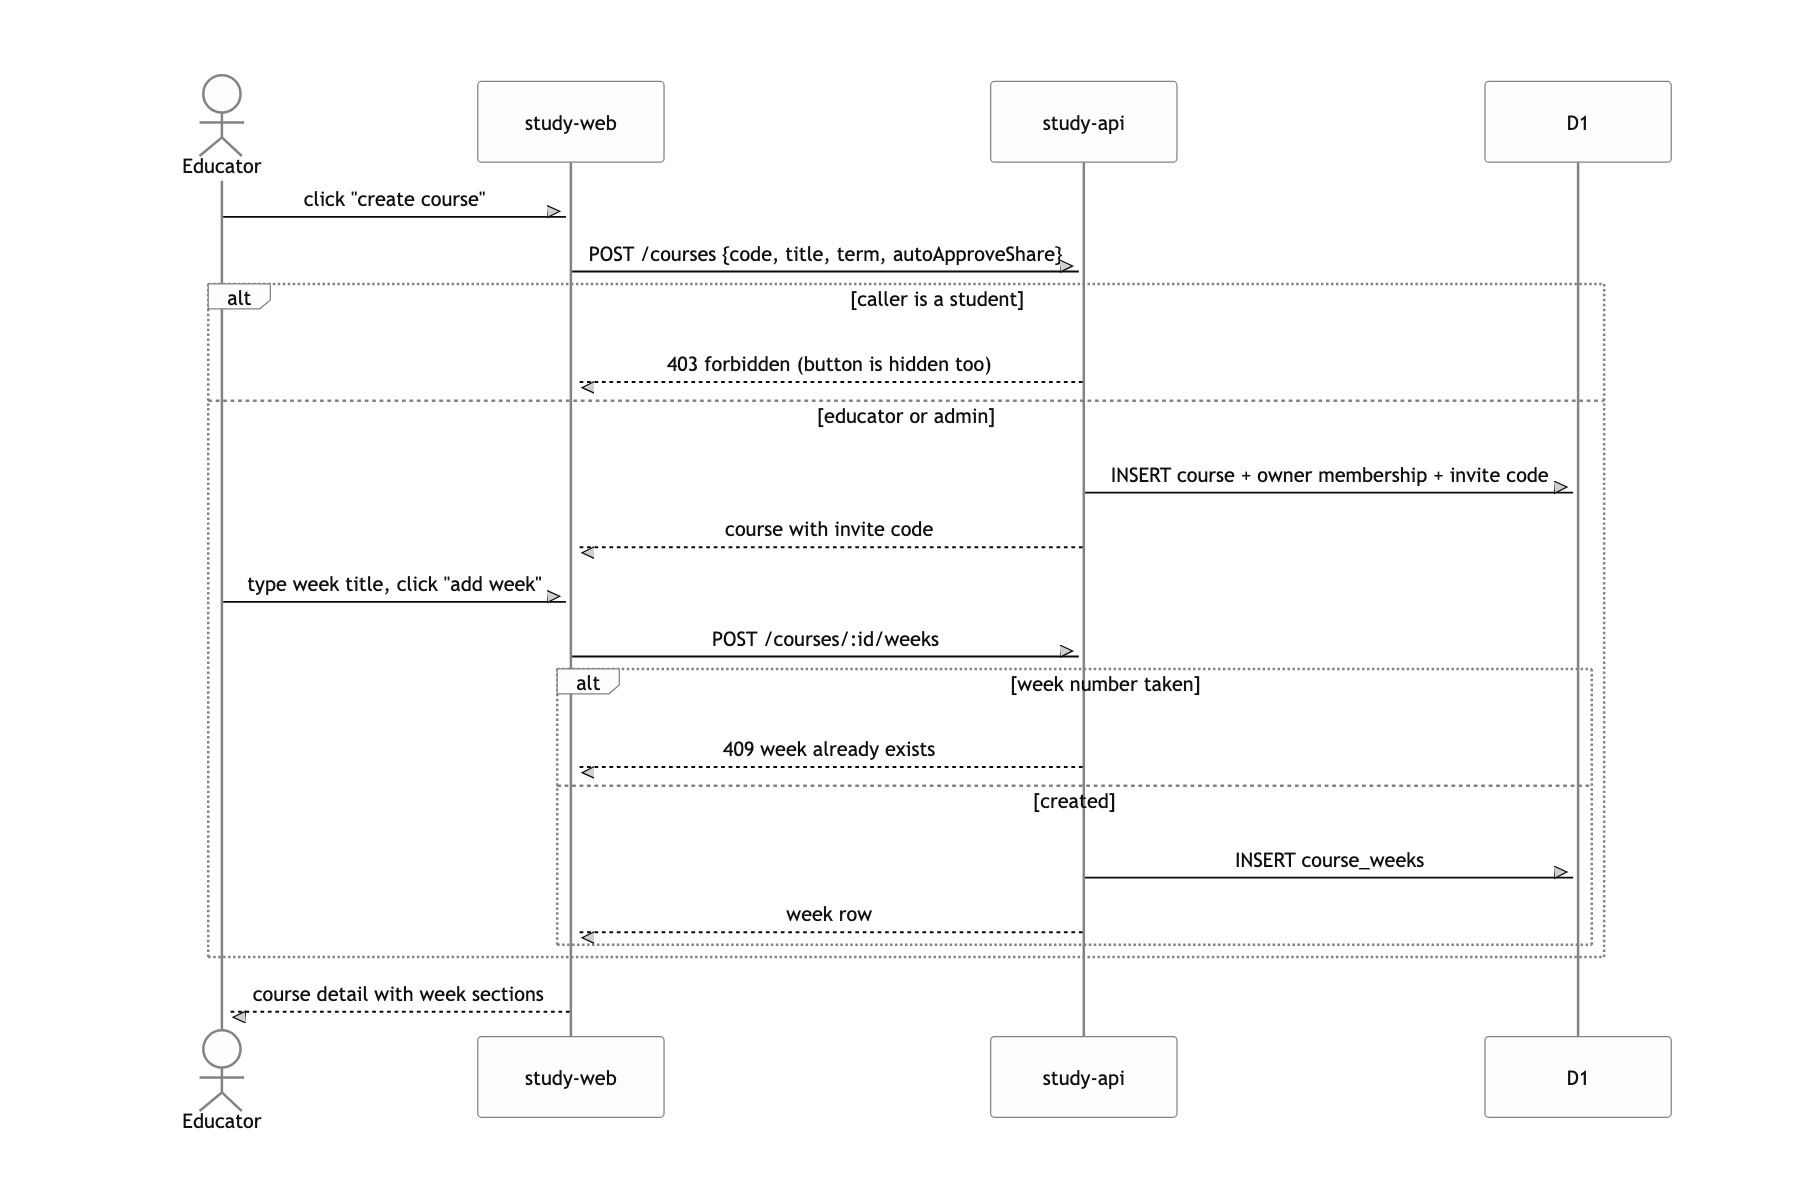
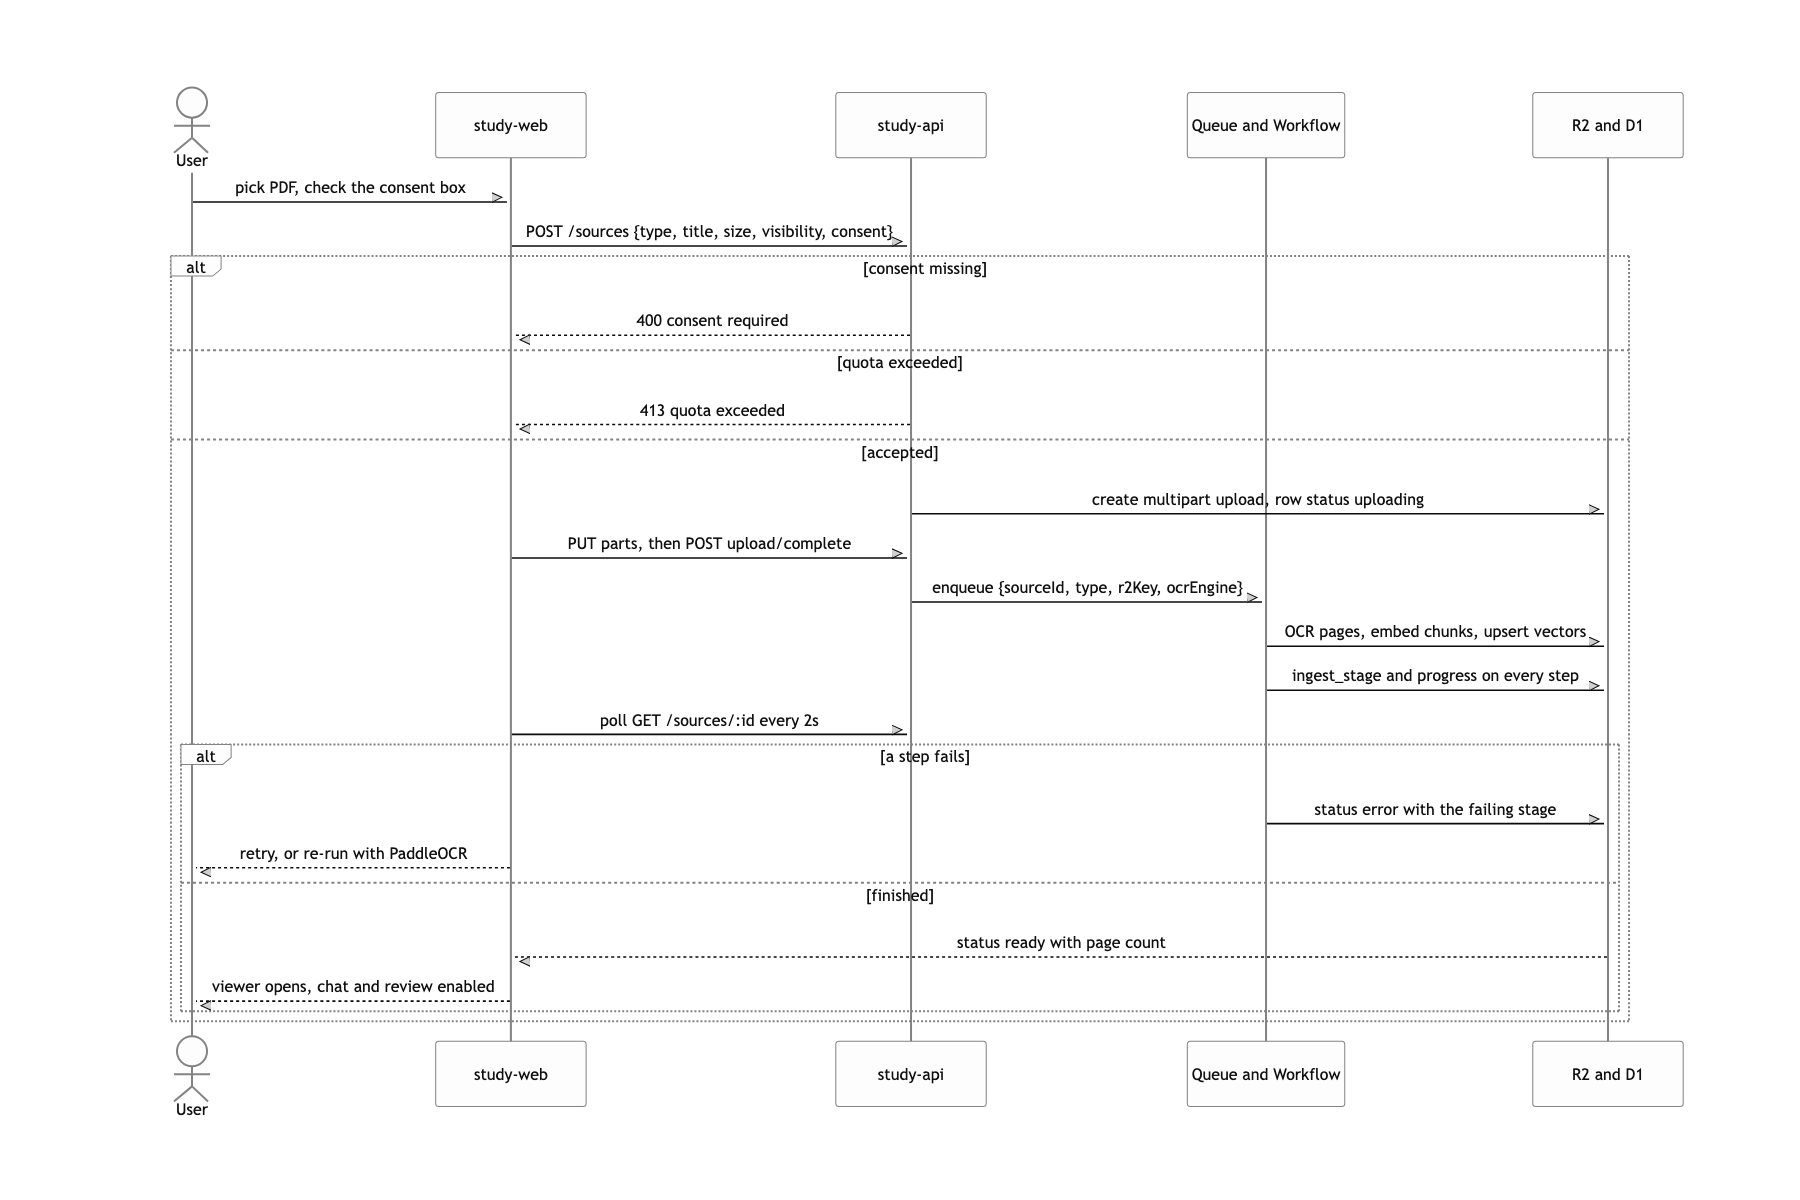
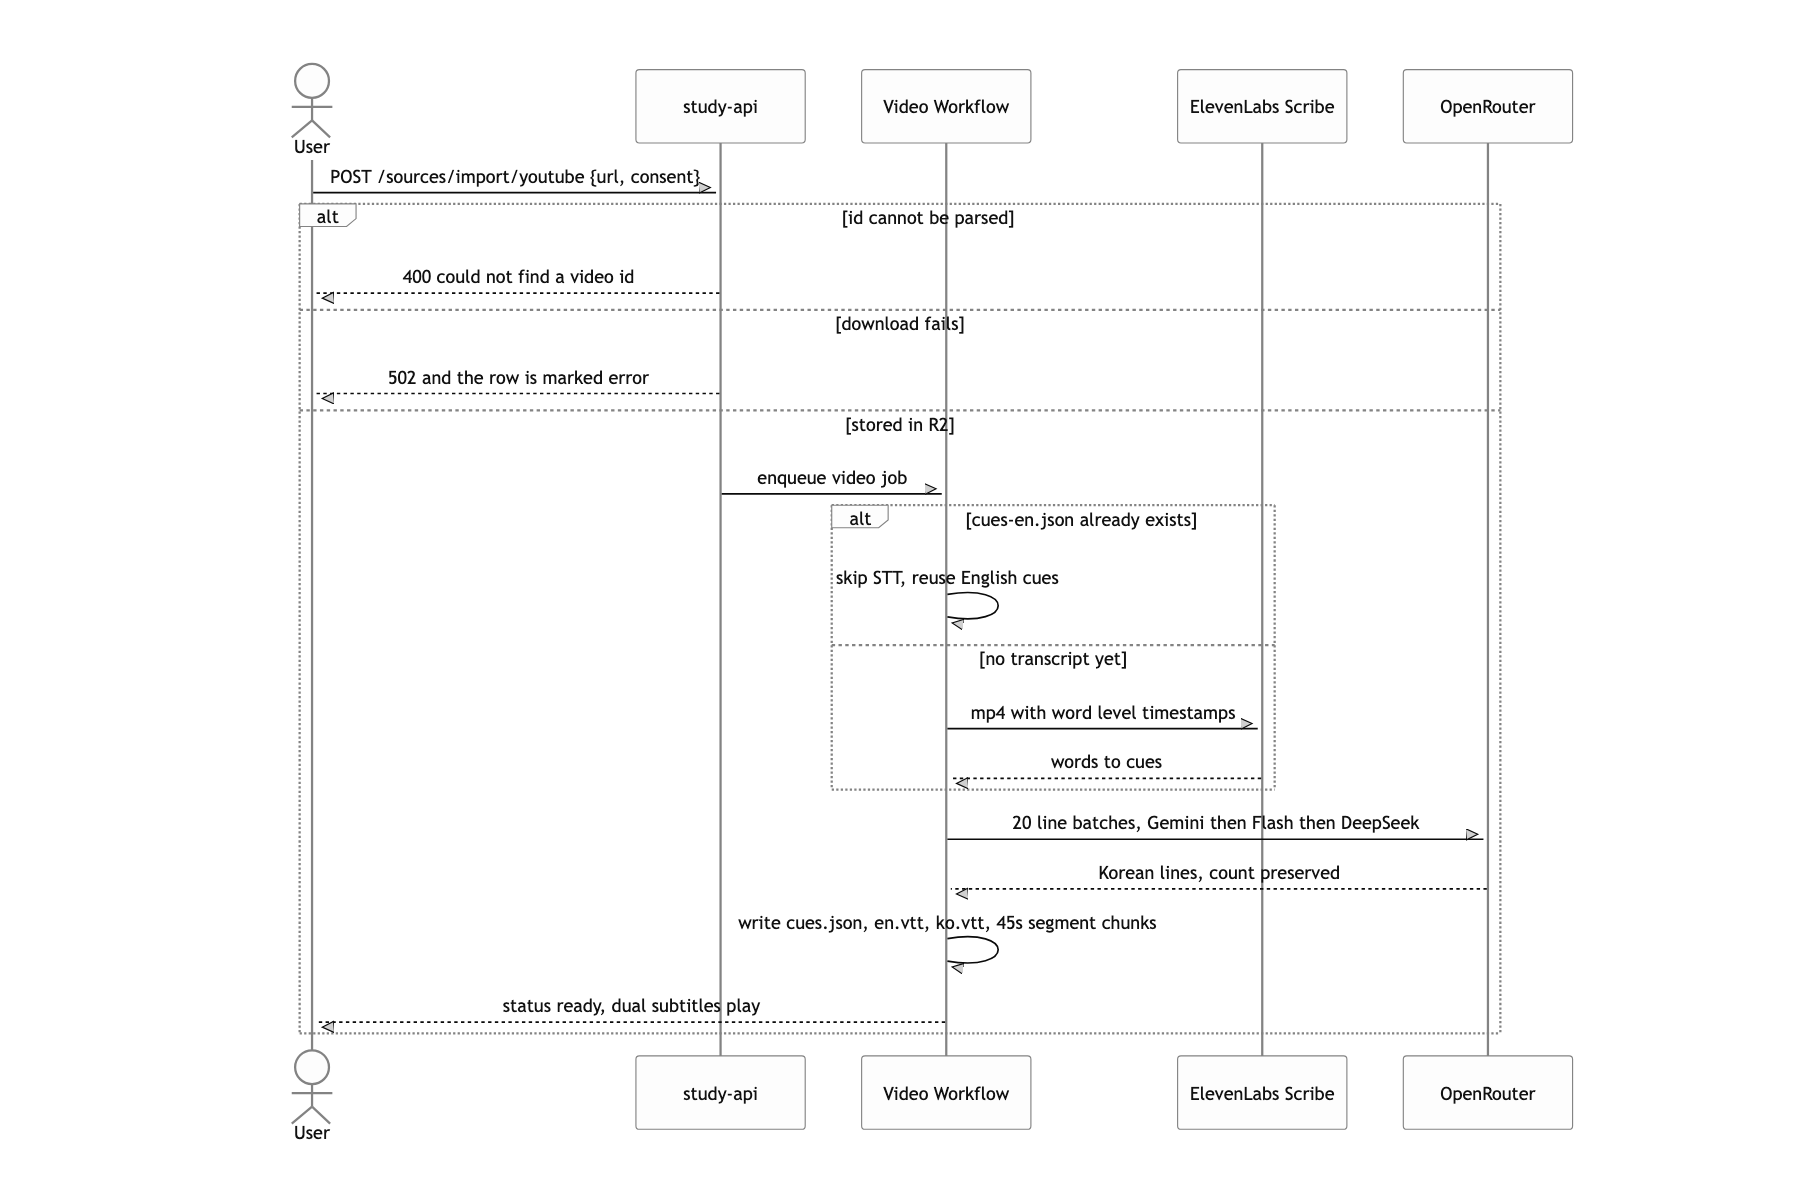
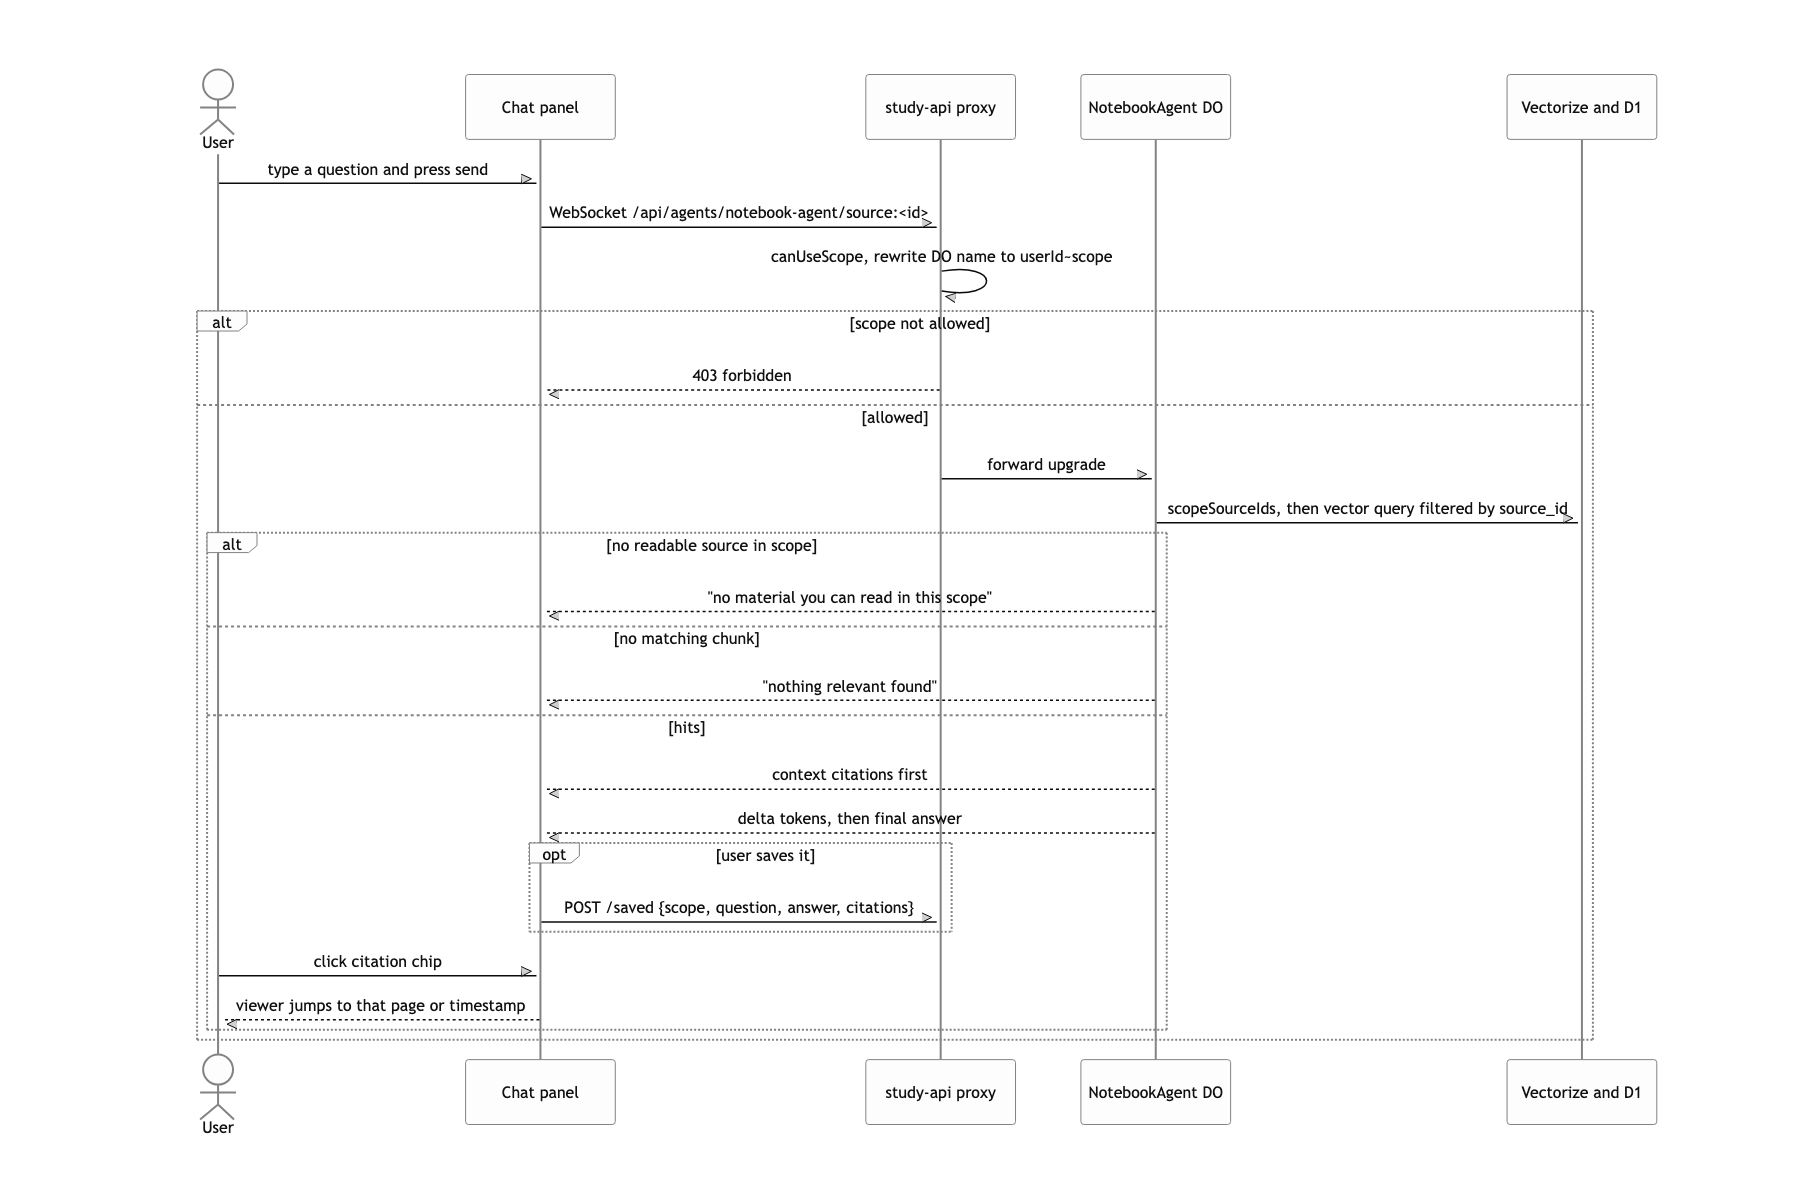
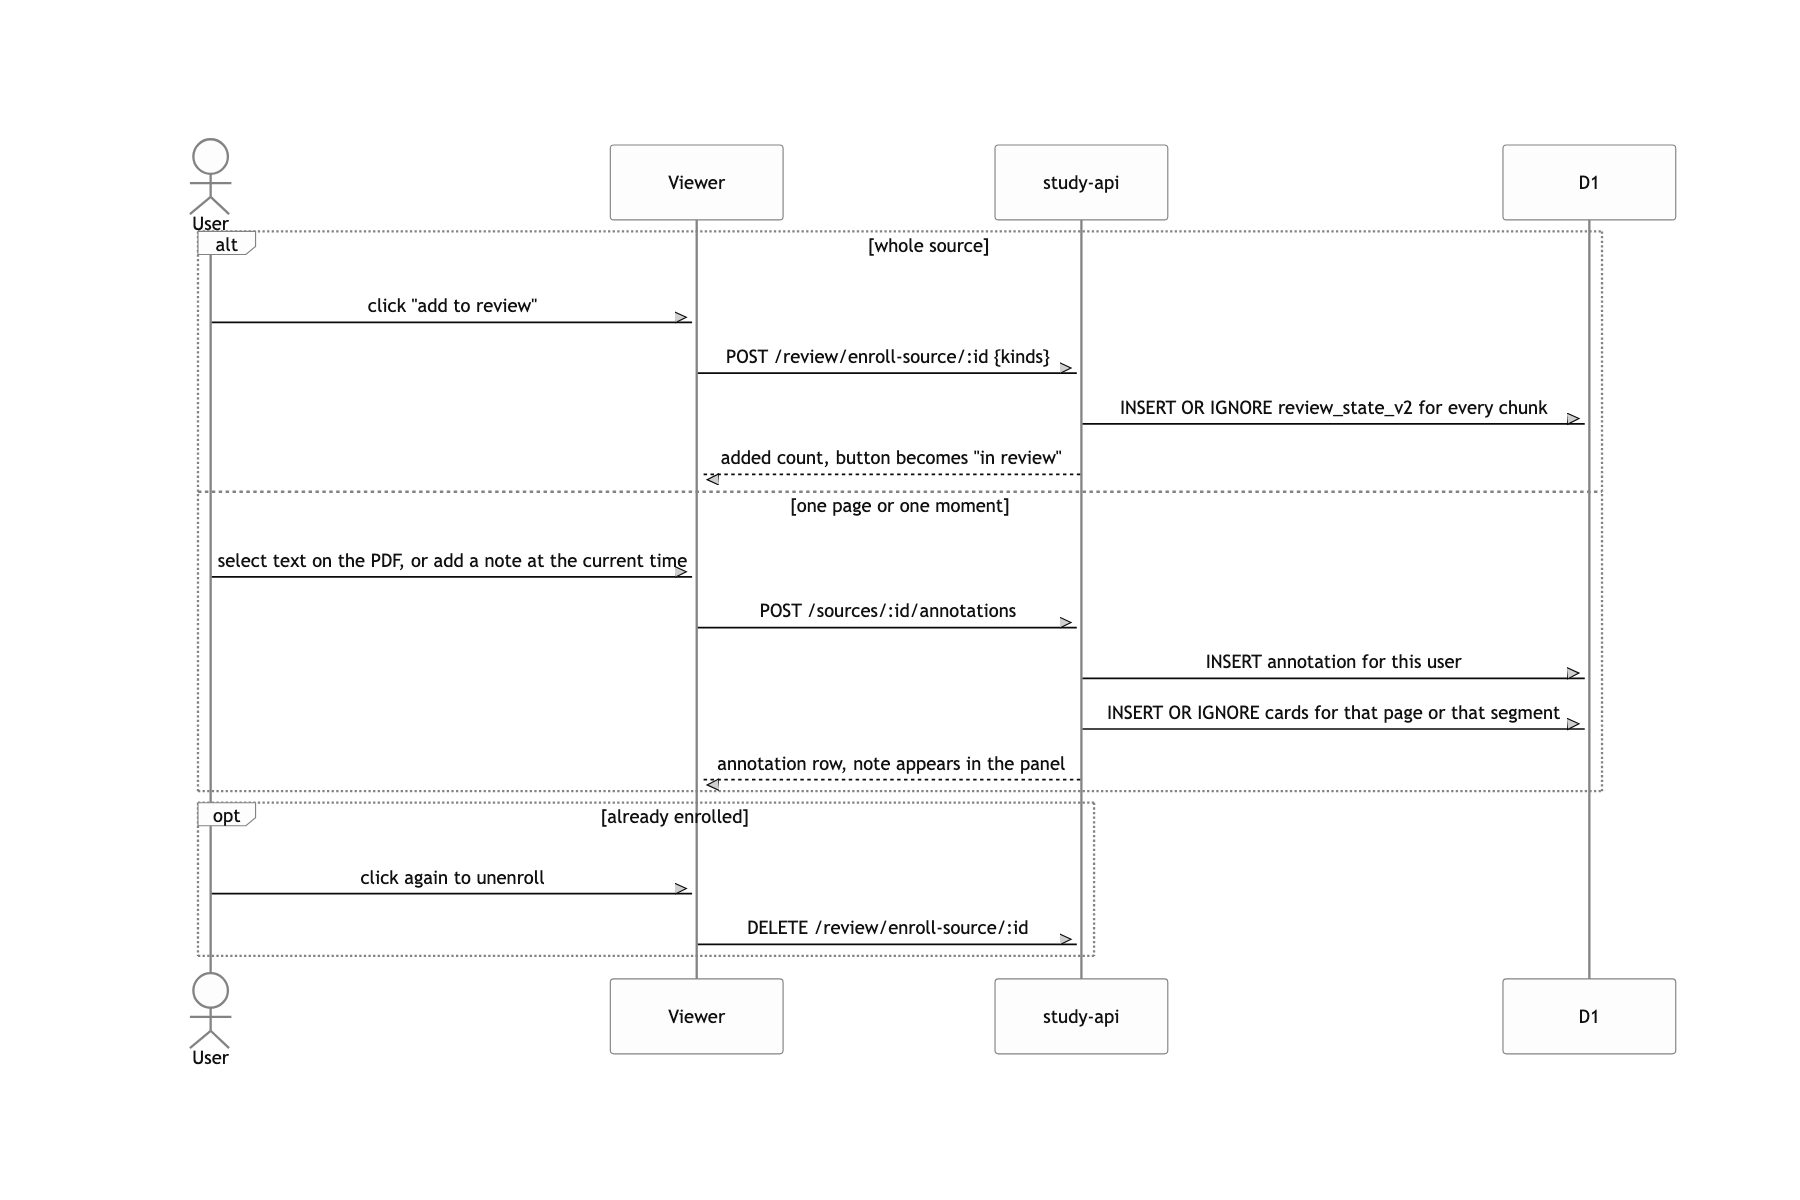
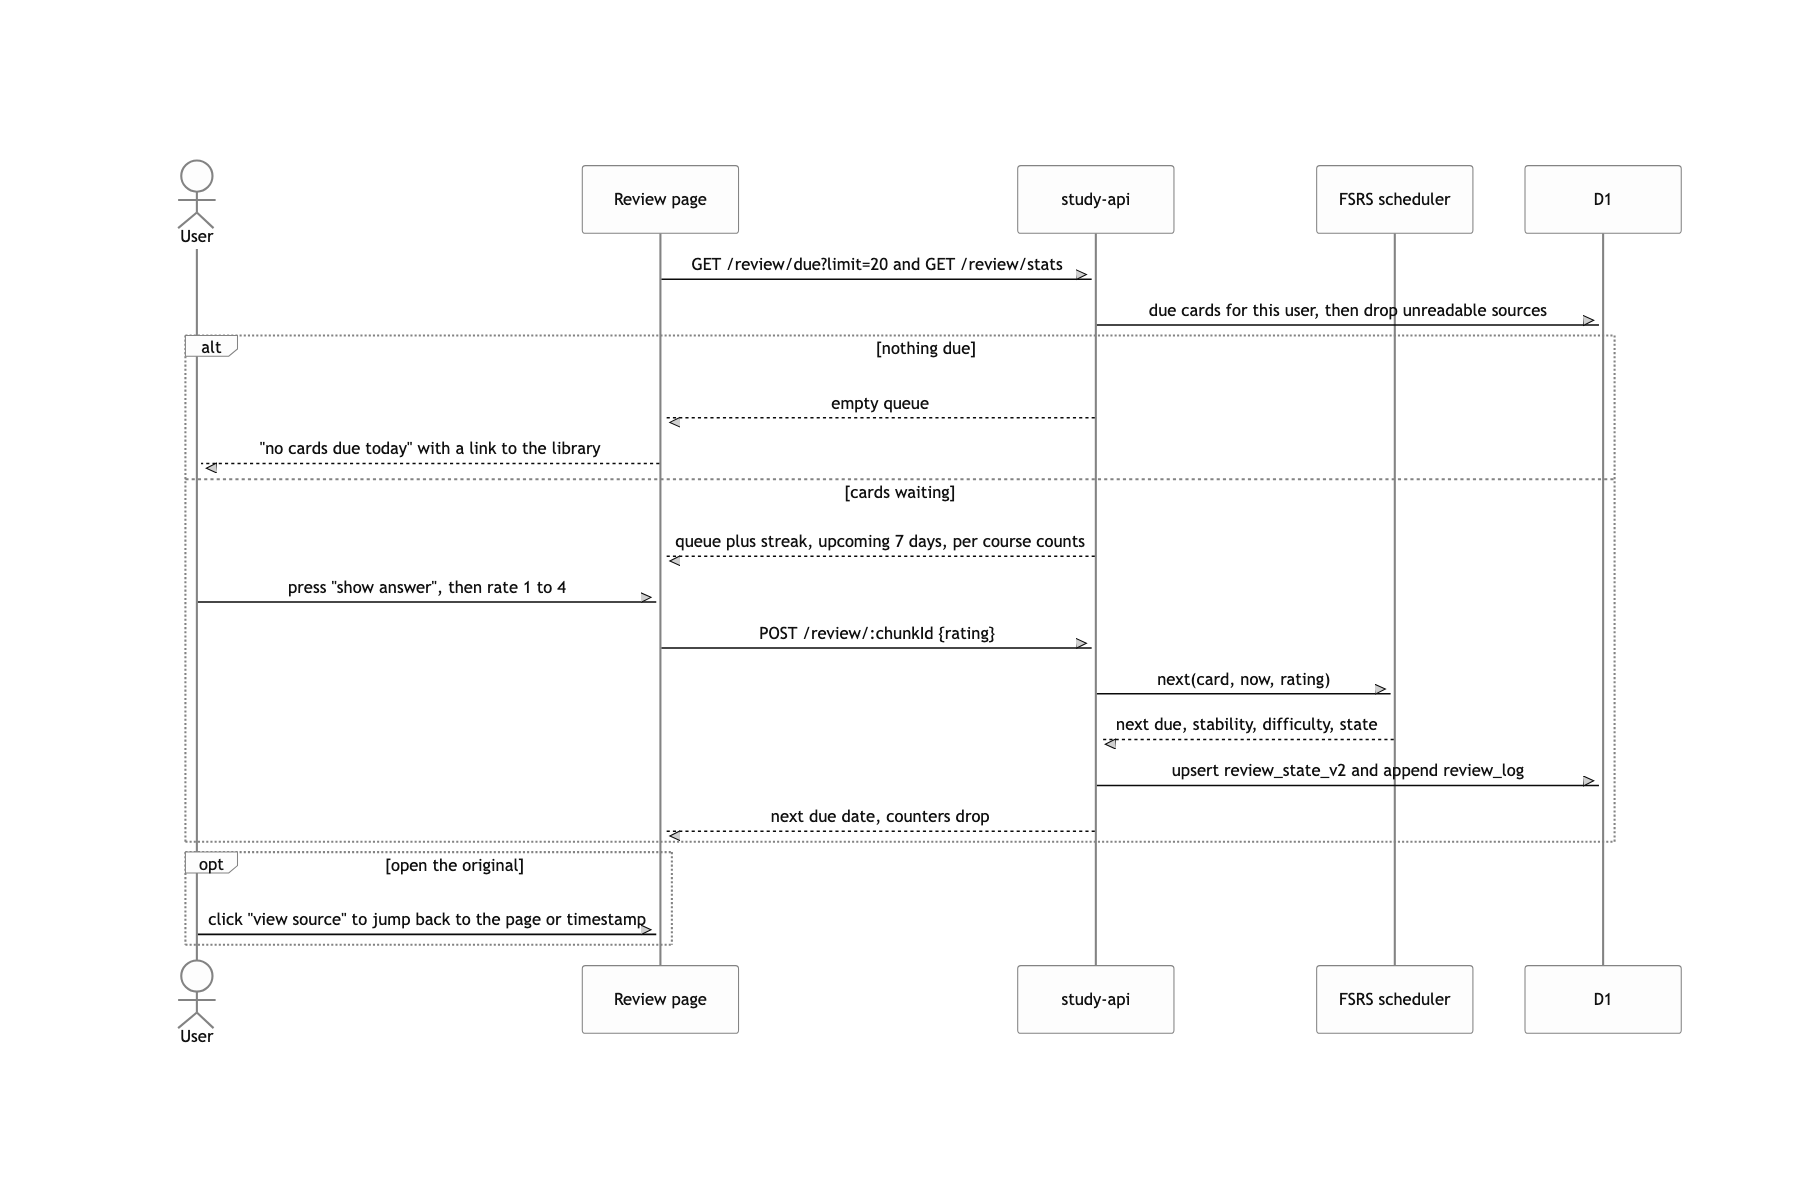
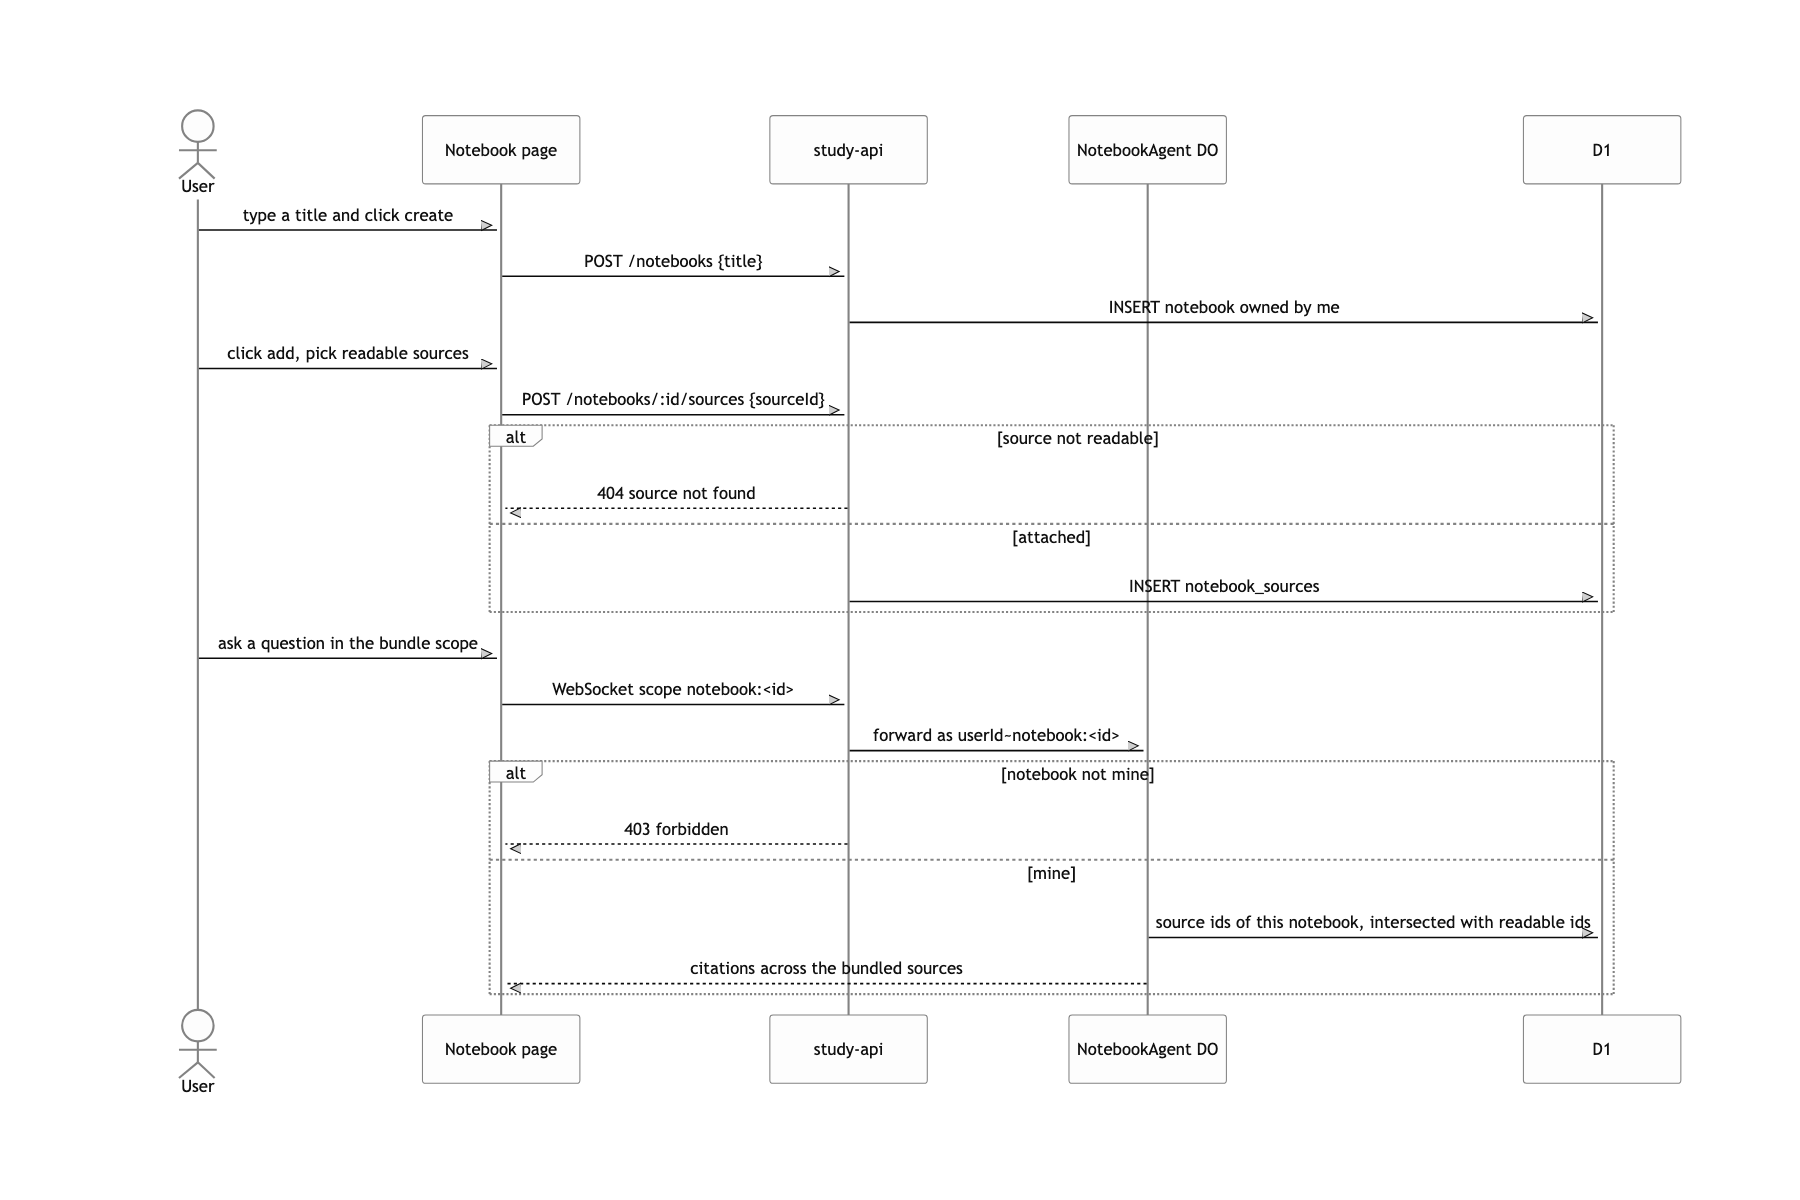
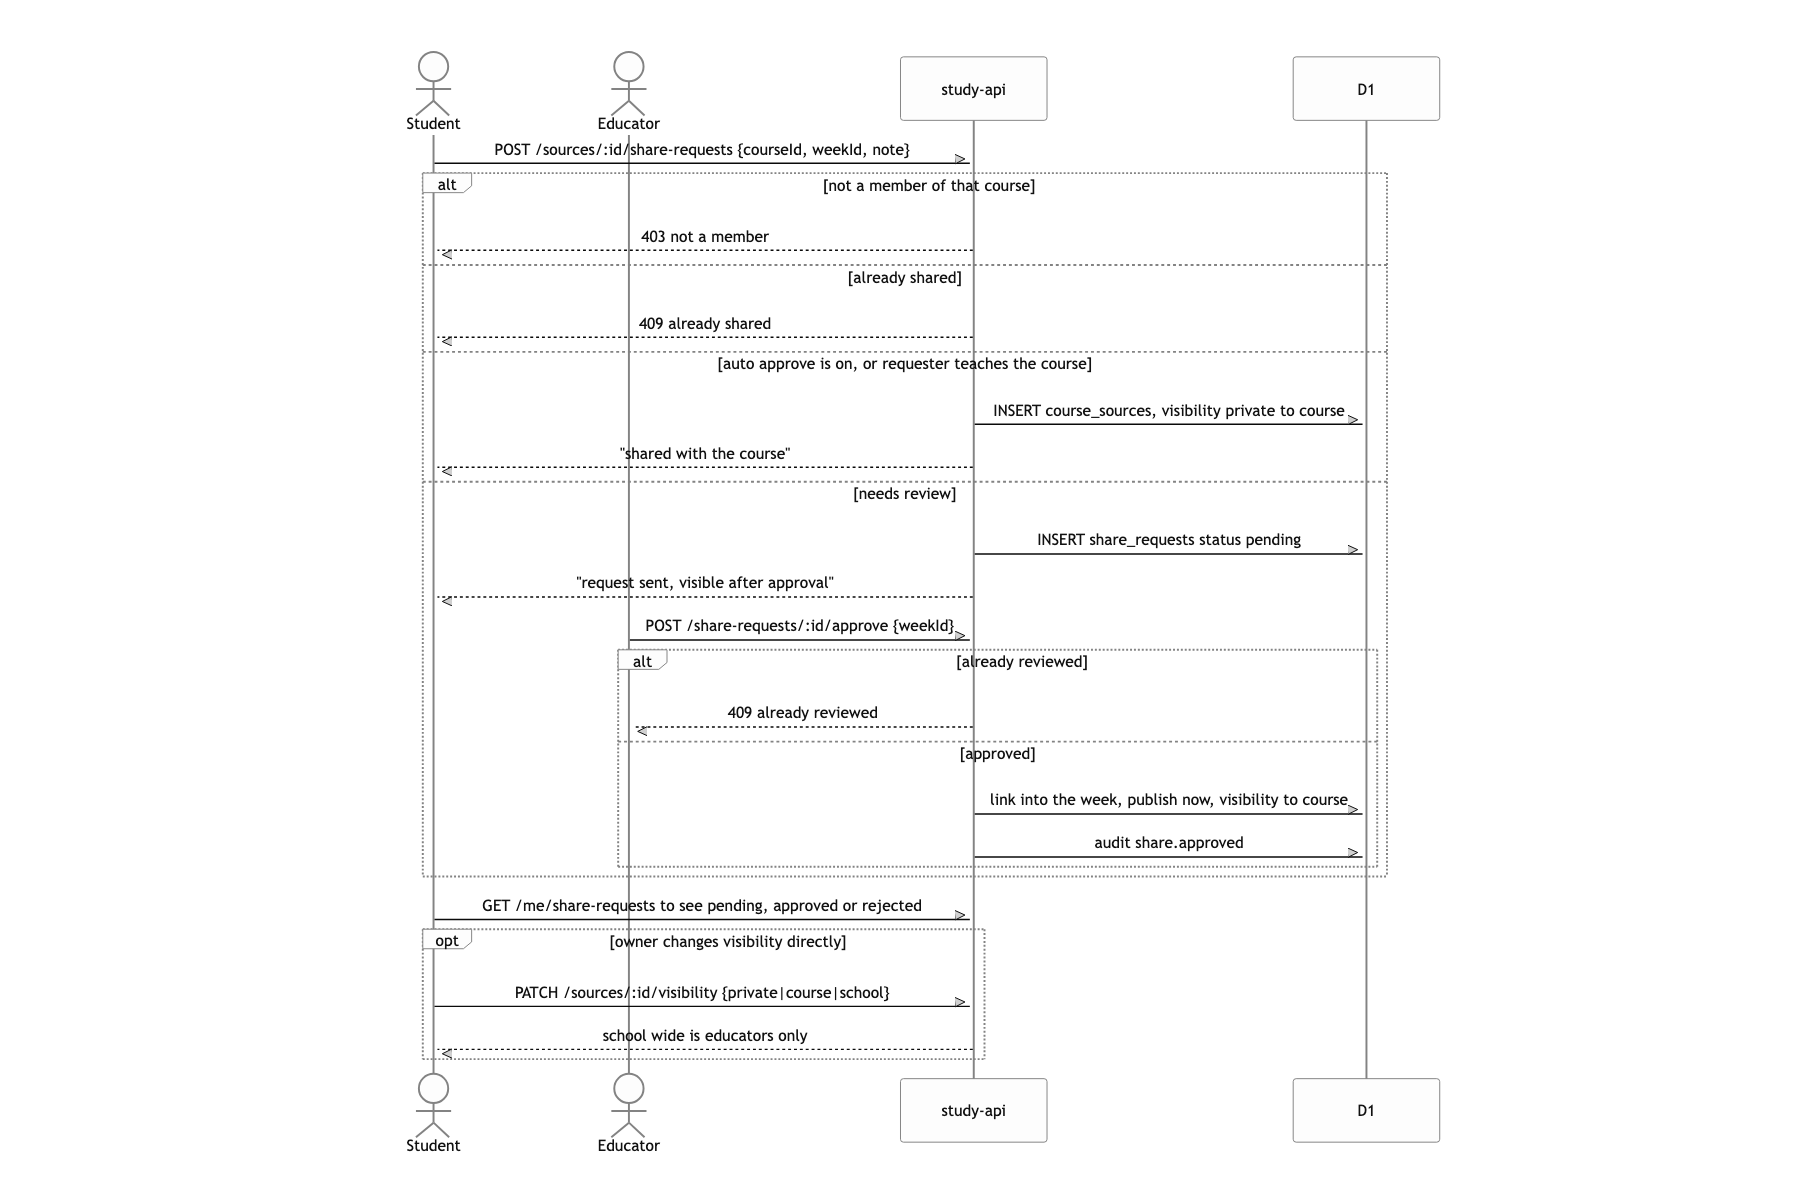
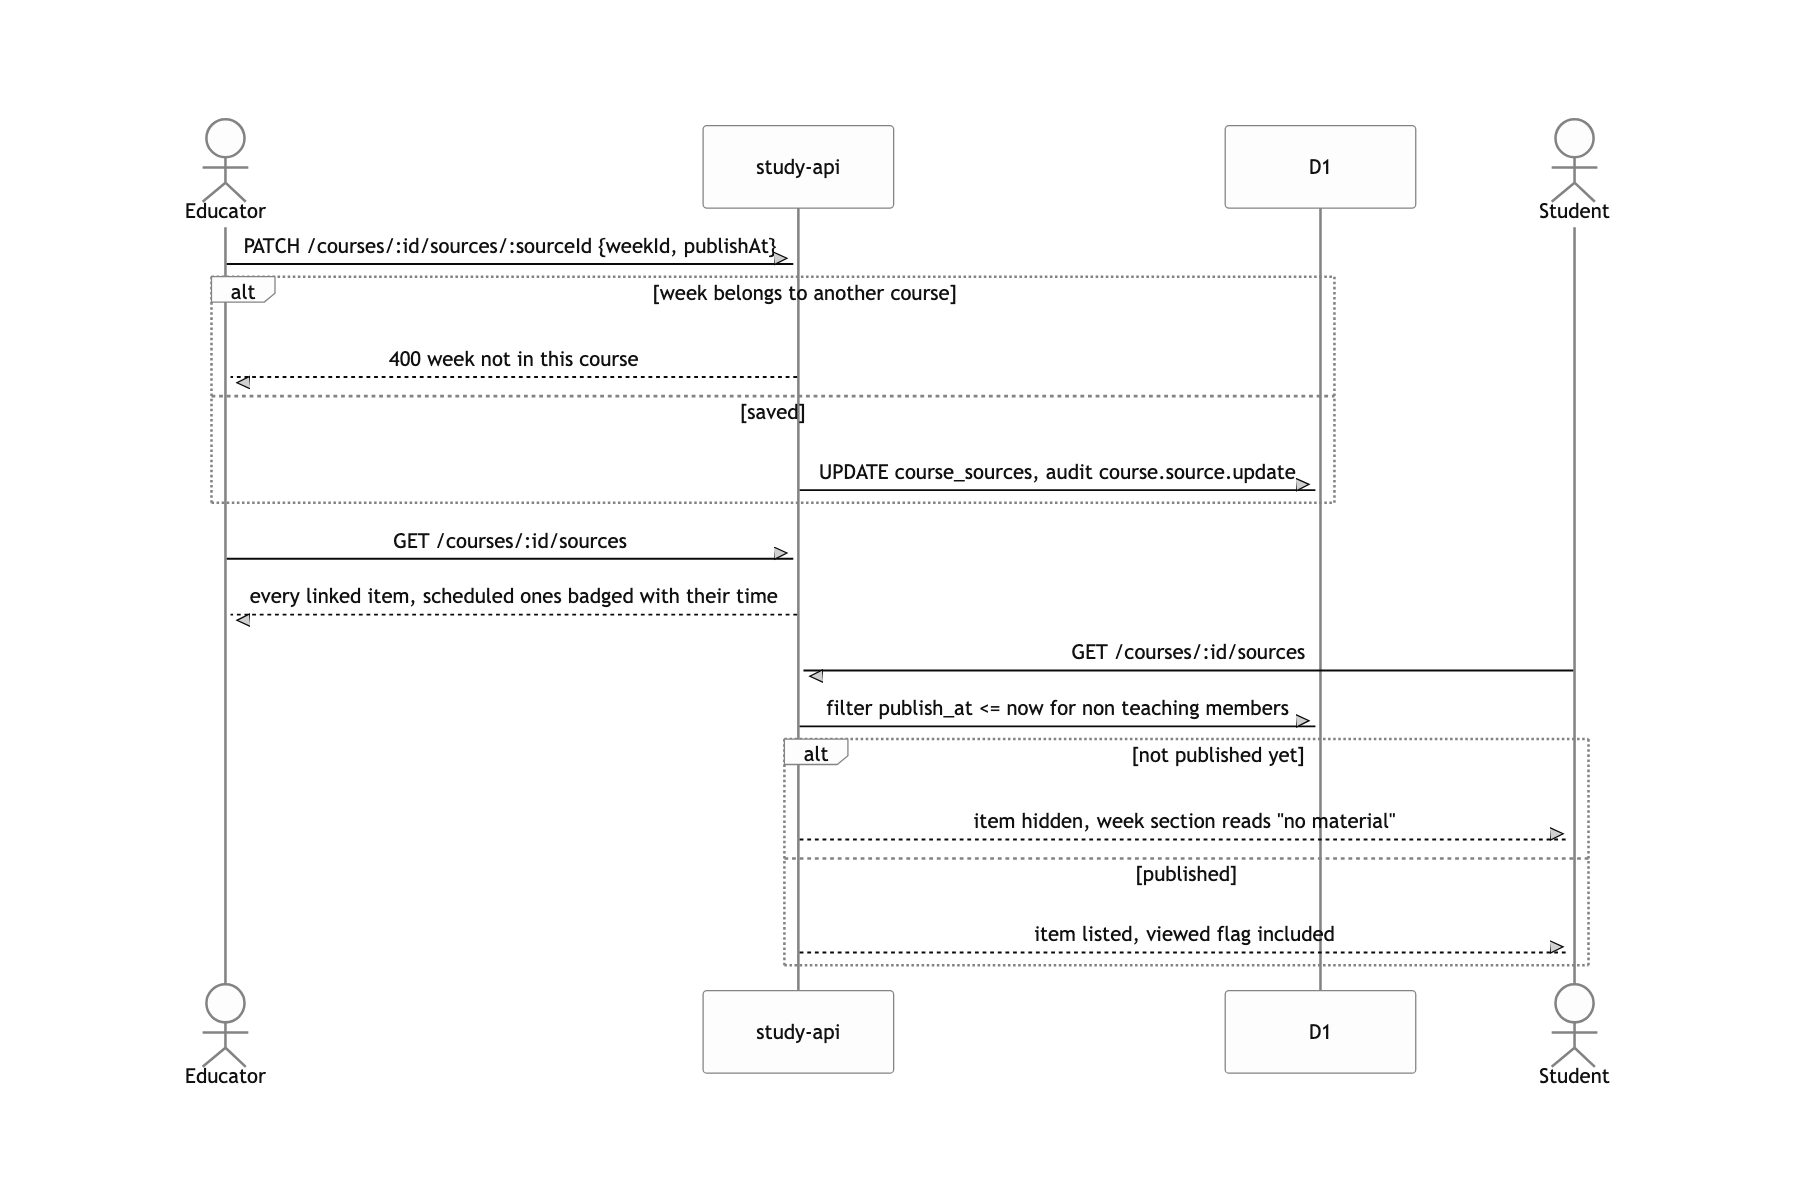
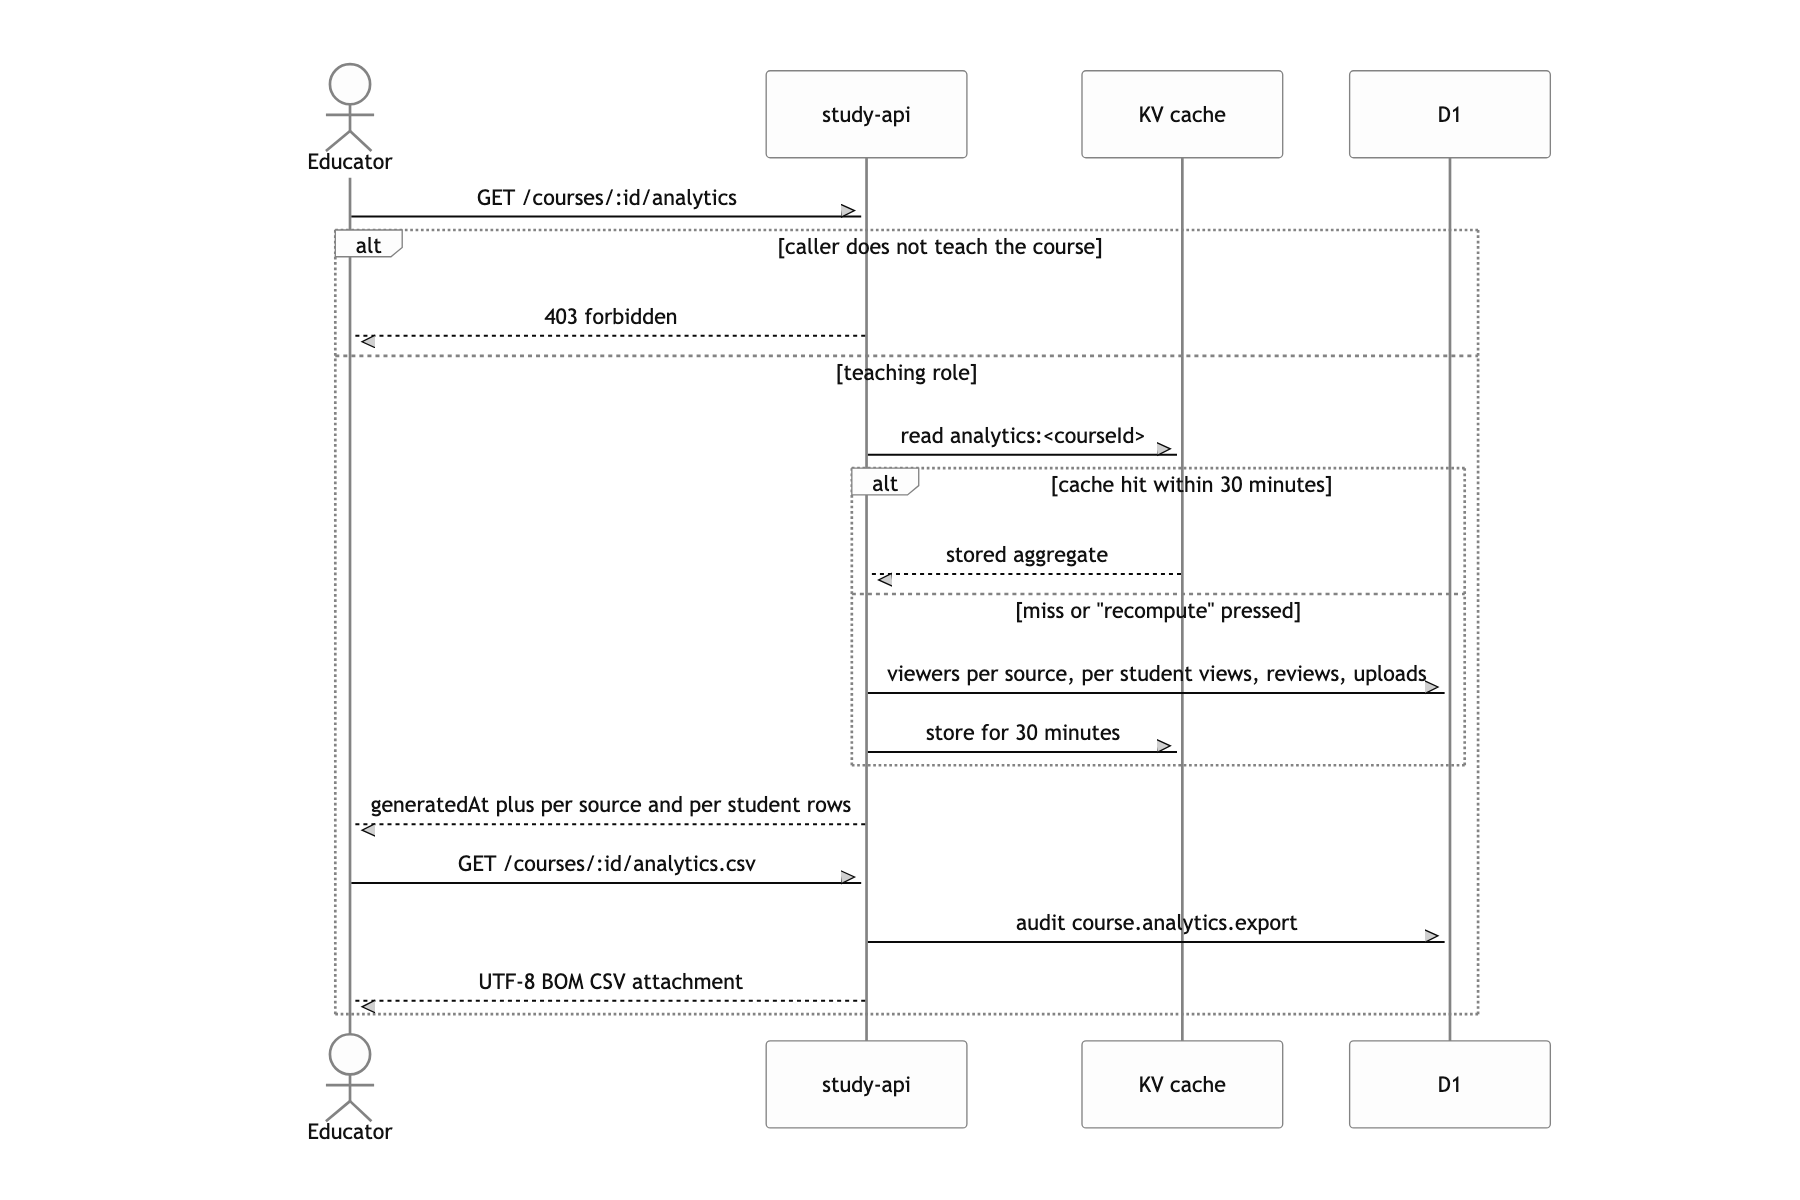
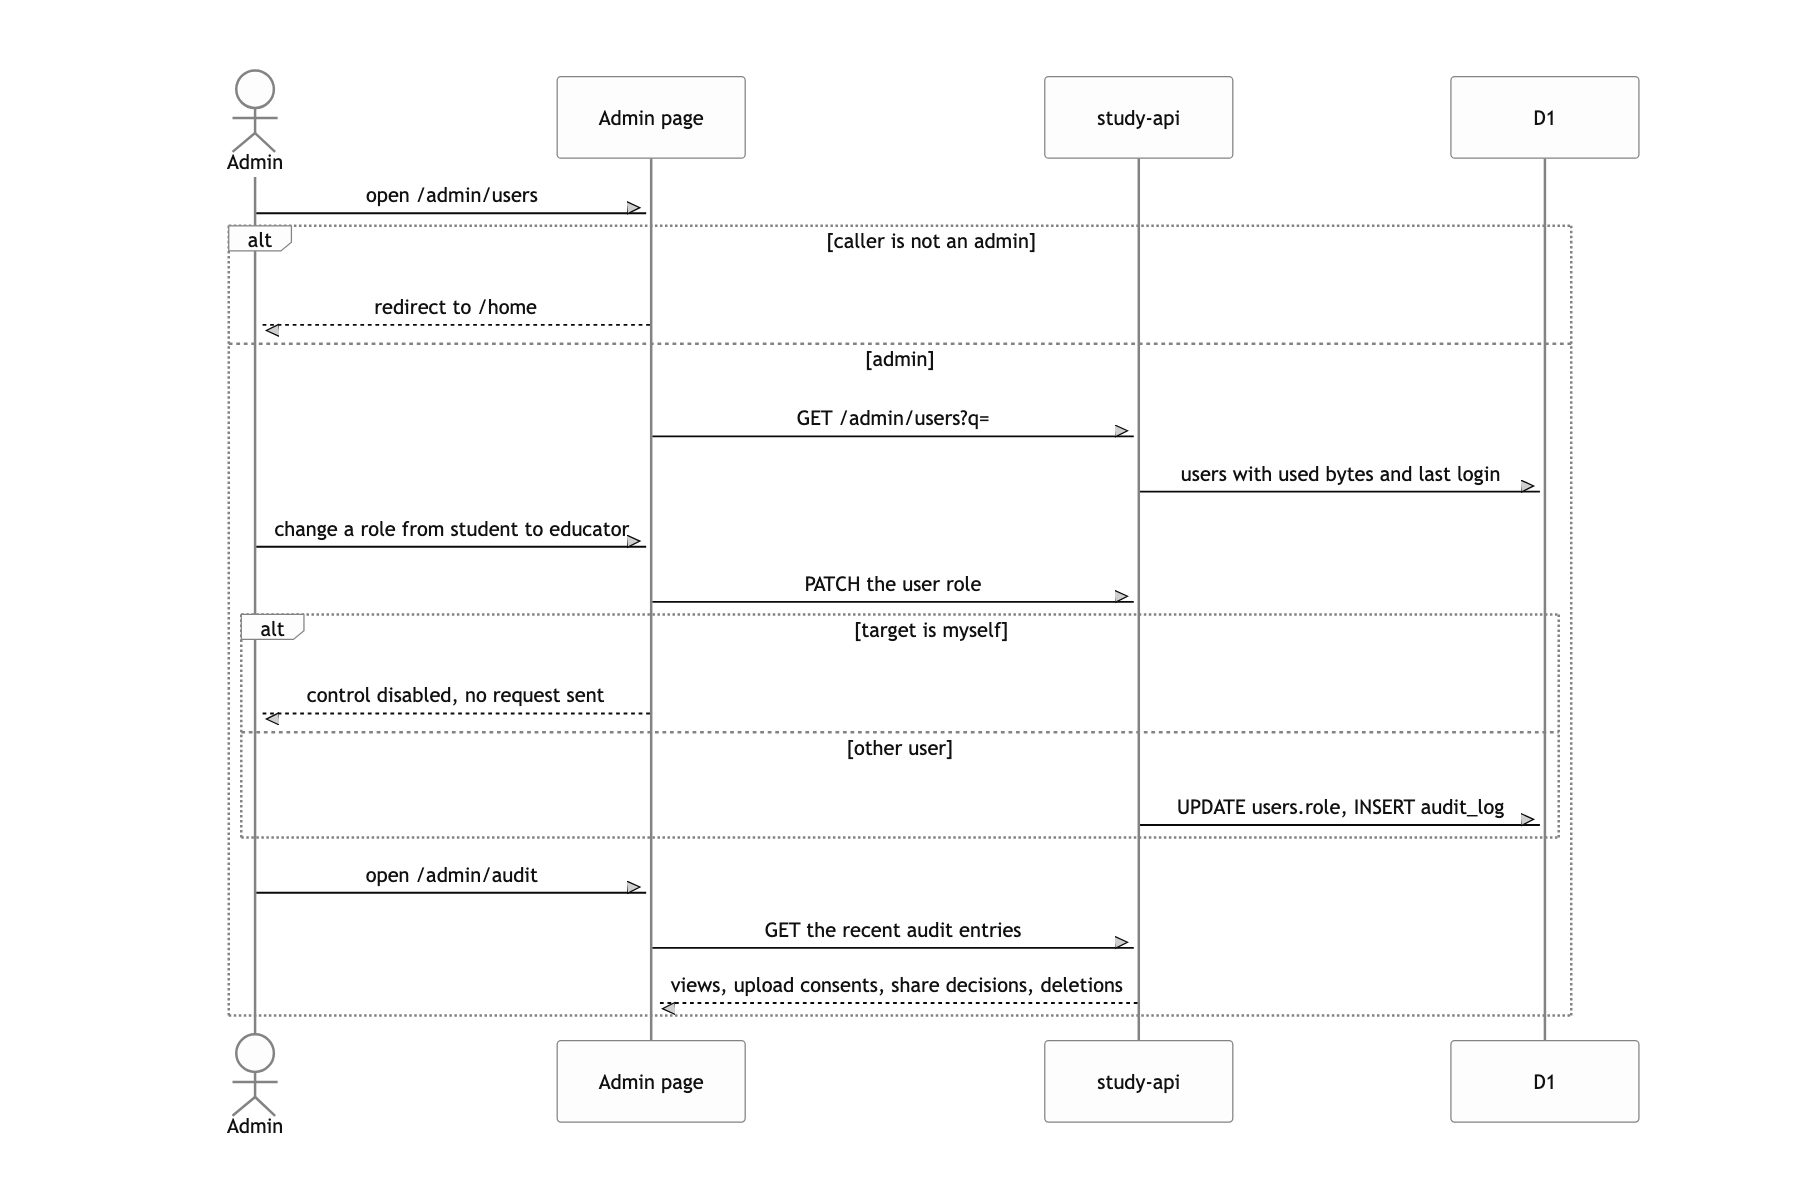
그림 캡션은 여전히 0건
가장 크게 비어 있는 곳은 그림입니다. OCR 컨테이너는 페이지 텍스트와 함께 추출한 그림을 base64로 NDJSON에 실어 보내는데, 워커가 그 줄을 JSON.parse나 atob 없이 통째로 버립니다. CPU 예산 때문이었어요. 그 결과 figures.json이 늘 빈 배열이고 caption-figures 단계는 0건으로 끝납니다. VLM 캡션과 그림 인용은 코드로는 다 있는데 실제로는 돌지 않는 셈이죠. 다시 만든다면 컨테이너가 그림을 R2에 직접 PUT하고 워커에는 키만 흘려보내겠습니다. 지금 구조에서 바이트를 워커로 통과시키려 한 게 처음부터 어긋난 선택이었습니다.
영상 오디오도 워커 메모리 안에서 ElevenLabs로 넘어가므로 두 시간 강의쯤이 한계입니다. 교육자용 학습 현황은 요청 시 집계라 실시간이 아니고, KV 바인딩이 없으면 캐시도 없이 매번 계산합니다. 수백 명이 동시에 붙기 전에 사전 집계로 옮겨야 해요. jobs 테이블과 sources.area, 옛 review_state처럼 쓰지 않으면서 지우지도 않은 잔재도 남아 있습니다. 테스트는 Playwright e2e에 기대고 있는데, pnpm test:unit이 가리키는 packages/access/*.test.ts는 아직 존재하지 않습니다. 권한 규칙처럼 한 곳에 모아 둔 로직일수록 단위 테스트가 먼저 있어야 했습니다.
