내가 쓴 일기 문장에서 단어를 뽑는 암기 카드 앱
내가 쓴 일기 문장에서만 단어를 뽑아 암기 카드로 만드는 도구
외울 단어를 내 문장에서 고르기
제2외국어 학습자 한 명이 쓰는 개인용 도구로 시작했습니다. 미리 만들어 둔 단어장을 외우는 방식이 아니라, 학습자가 직접 쓴 문장에서 뽑아낸 단어만 카드가 되는 구조입니다.
파이프라인은 한국어 문장을 받아 번역하고, 단어를 뽑고, 원형을 찾고, 발음을 붙이고, 카드로 묶는 단계로 이어집니다. 이 단계를 사람이 도구마다 옮겨 다니며 하지 않도록, 문장을 넣으면 카드까지 한 번에 나오게 이었습니다.
제약은 두 가지였습니다. 입력은 텔레그램 봇으로 받고, 최종 결과물은 학습자가 쓰던 Anki 덱(.apkg) 파일로 나와야 합니다. 그리고 상주 서버 없이, 요청이 들어올 때만 도는 구조여야 했습니다.
그래서 이 글에서는 상주 서버 없이 이 파이프라인을 굴린 방법과 Anki 덱을 워커 안에서 굽는 이야기만 다룹니다. FSRS 복습 스케줄링, 오프라인 동기화, Expo 웹 폴백은 각각 따로 다룰 가치가 있는 이야기라 이 글에서는 접습니다.
상주 서버 없이 봇 열넷과 앱 하나
Cloudflare Workers + D1 + R2
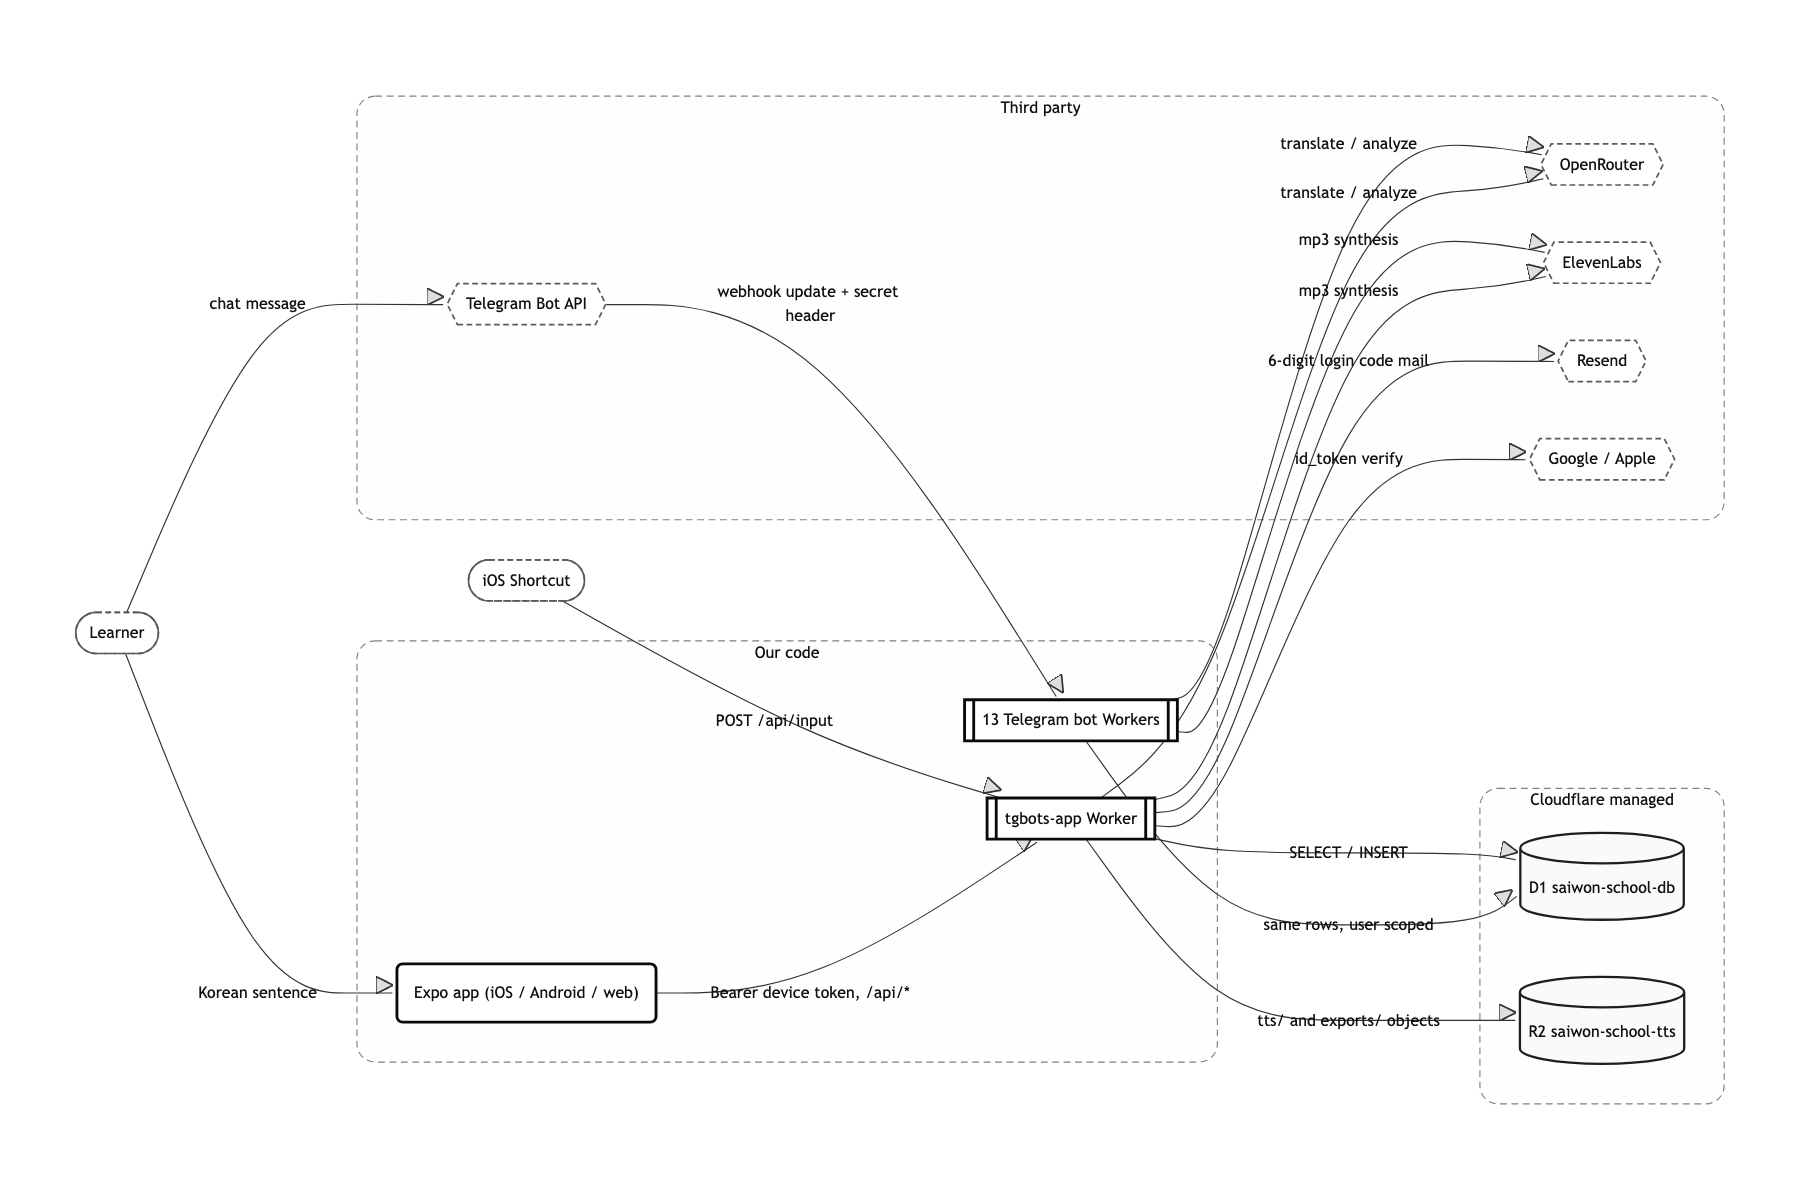
텔레그램 웹훅은 짧은 시간 안에 200을 돌려주지 않으면 재시도가 쏟아집니다. 요청이 있을 때만 깨어나고 전 세계 엣지에서 도는 워커가 이 트래픽 모양에 정확히 맞았어요. 오디오는 R2, 나머지는 D1(SQLite) 한 벌로 끝냈습니다. 상주 서버 없이 사실상 무료 티어로 굴려야 했고, 대신 Node API도 파일시스템도 없는 workerd 위에서 모든 걸 해결해야 했습니다.
pnpm 워크스페이스에 워커 14개, D1은 하나
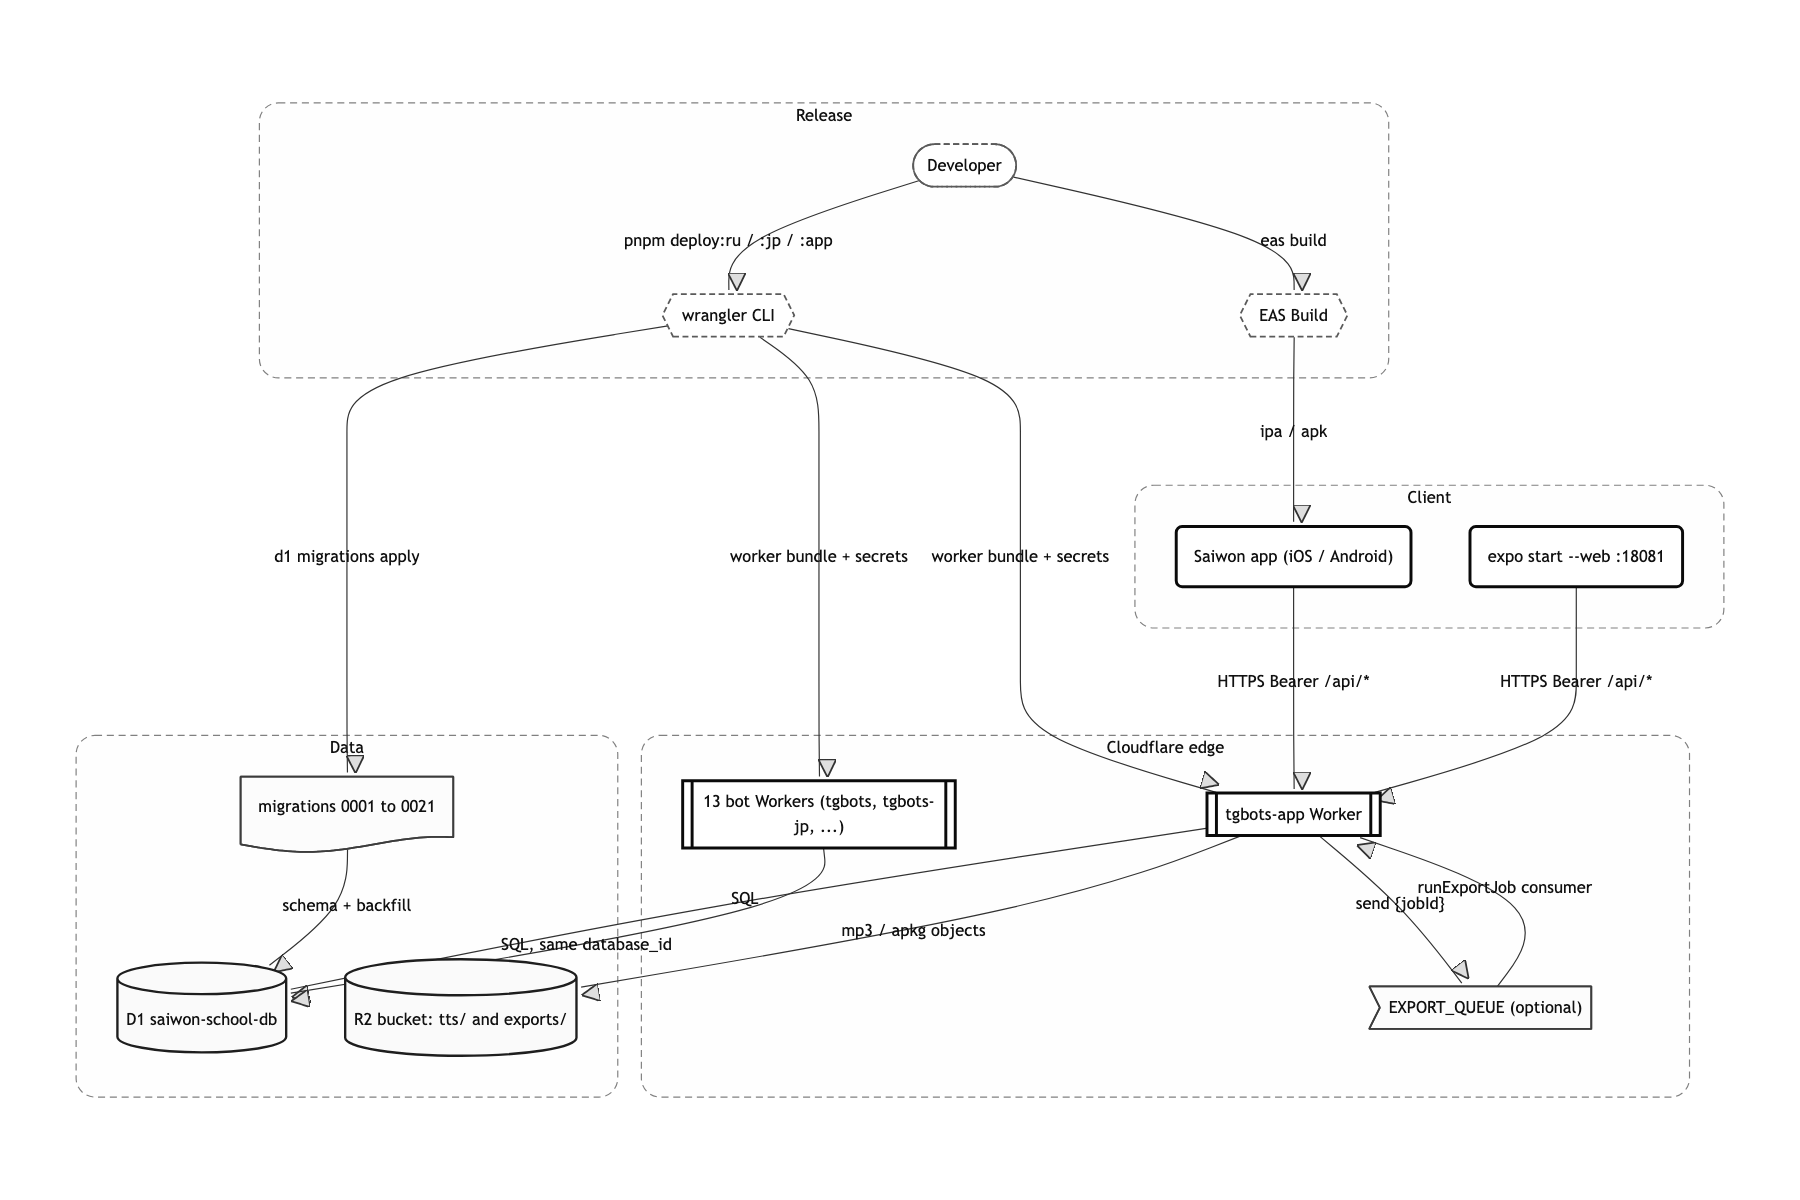
텔레그램은 봇 토큰 하나에 웹훅 하나입니다. 그래서 봇마다 워커를 나눠 배포하되(bots/ru, bots/jp 등 13개), 학습 로직은 packages/shared에 한 벌만 두고 앱 전용 워커 bots/app이 같은 코드를 씁니다. 시크릿은 워커별로 다르지만 데이터는 한곳에 모여야 했습니다. wrangler.toml 14개가 같은 database_id를 가리키고, 마이그레이션은 migrations/에서 한 줄기로만 갑니다.
번역만 동기, TTS·단어추출·질문생성은 waitUntil 뒤로
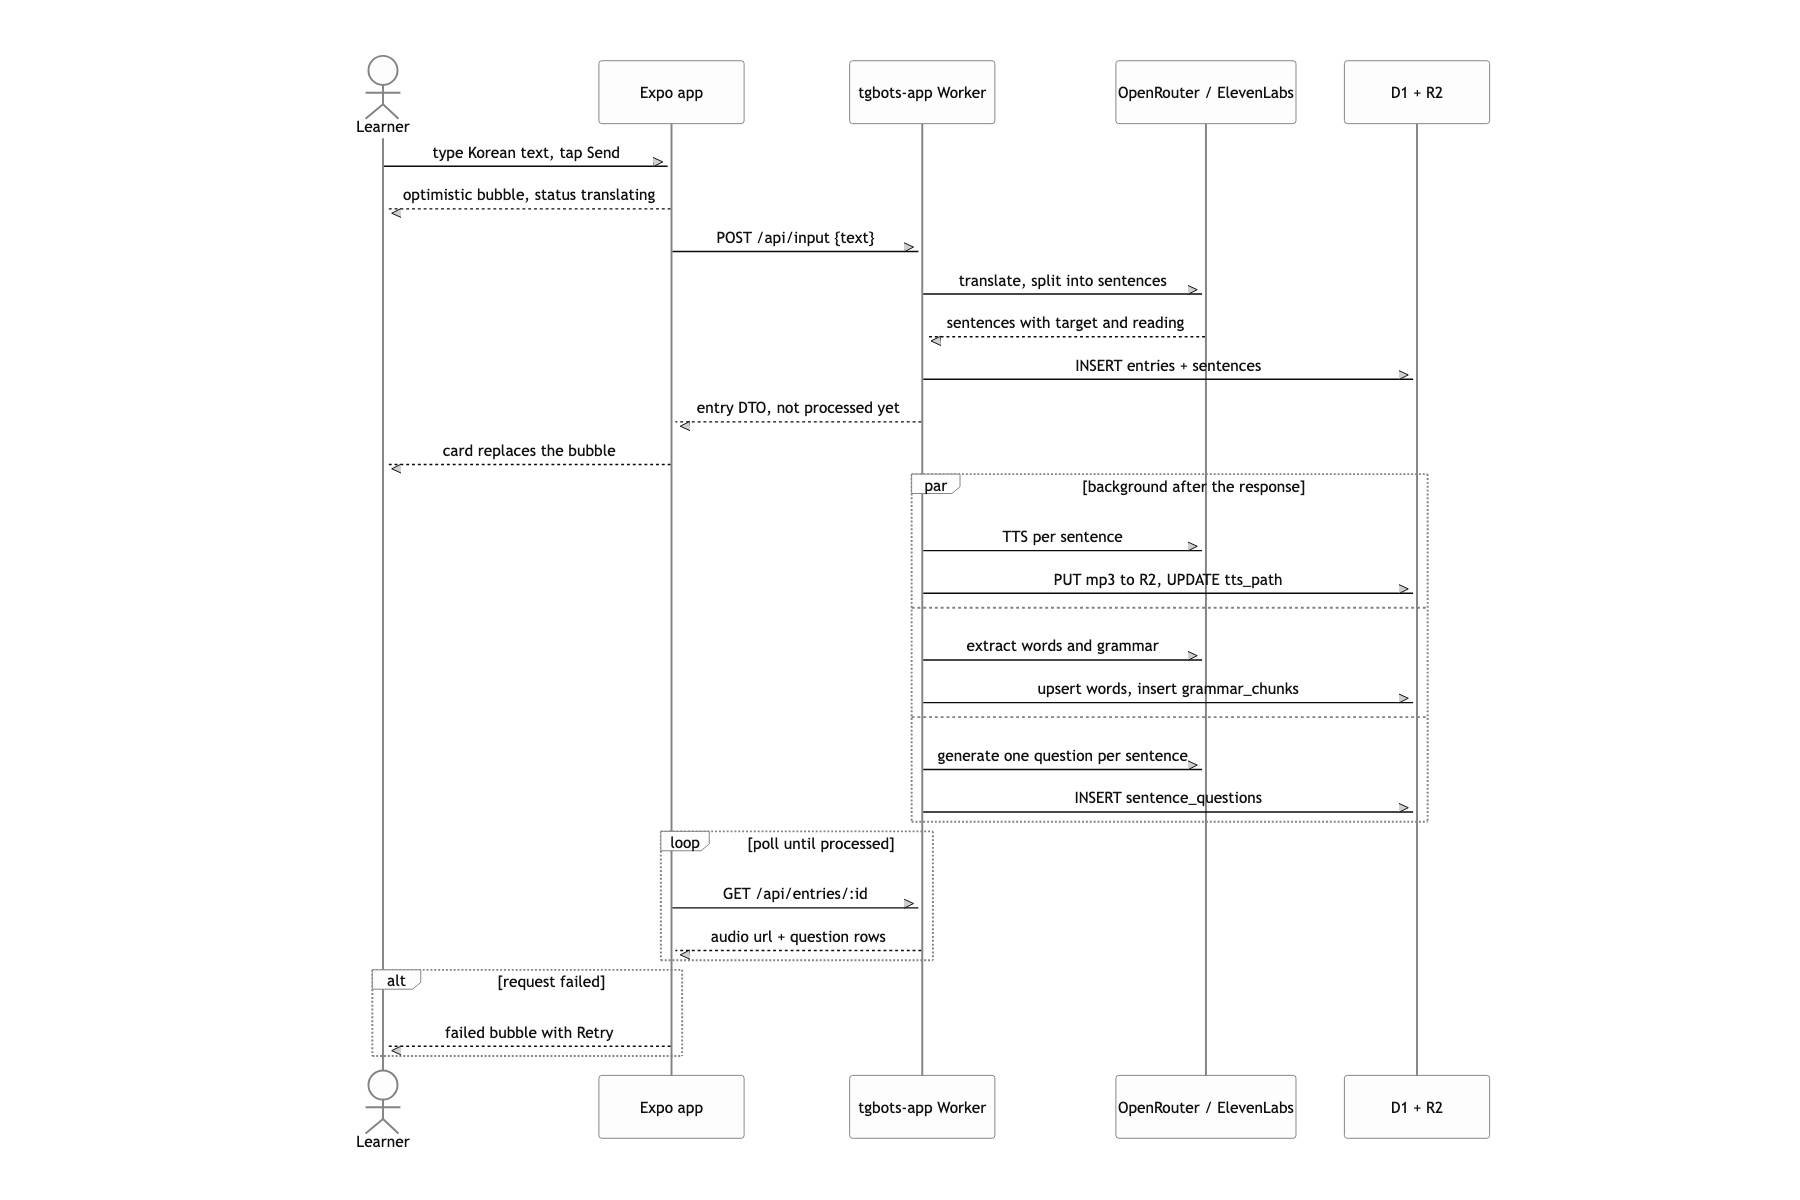
문장 세 개짜리 일기면 TTS 호출도 세 번입니다. 이걸 다 기다리면 사용자는 20초 넘게 빈 화면을 봐야 해요. 번역만 기다려 카드를 먼저 띄우고, 나머지는 응답을 보낸 뒤에 이어서 돌립니다. 백그라운드가 실패해도 본문은 남아야 해서 Promise.allSettled로 조각마다 독립 실패를 허용하고, 다 끝나면 processed_at을 찍어 앱이 폴링을 멈추게 했습니다.
번역은 즉시, 나머지는 응답 뒤에
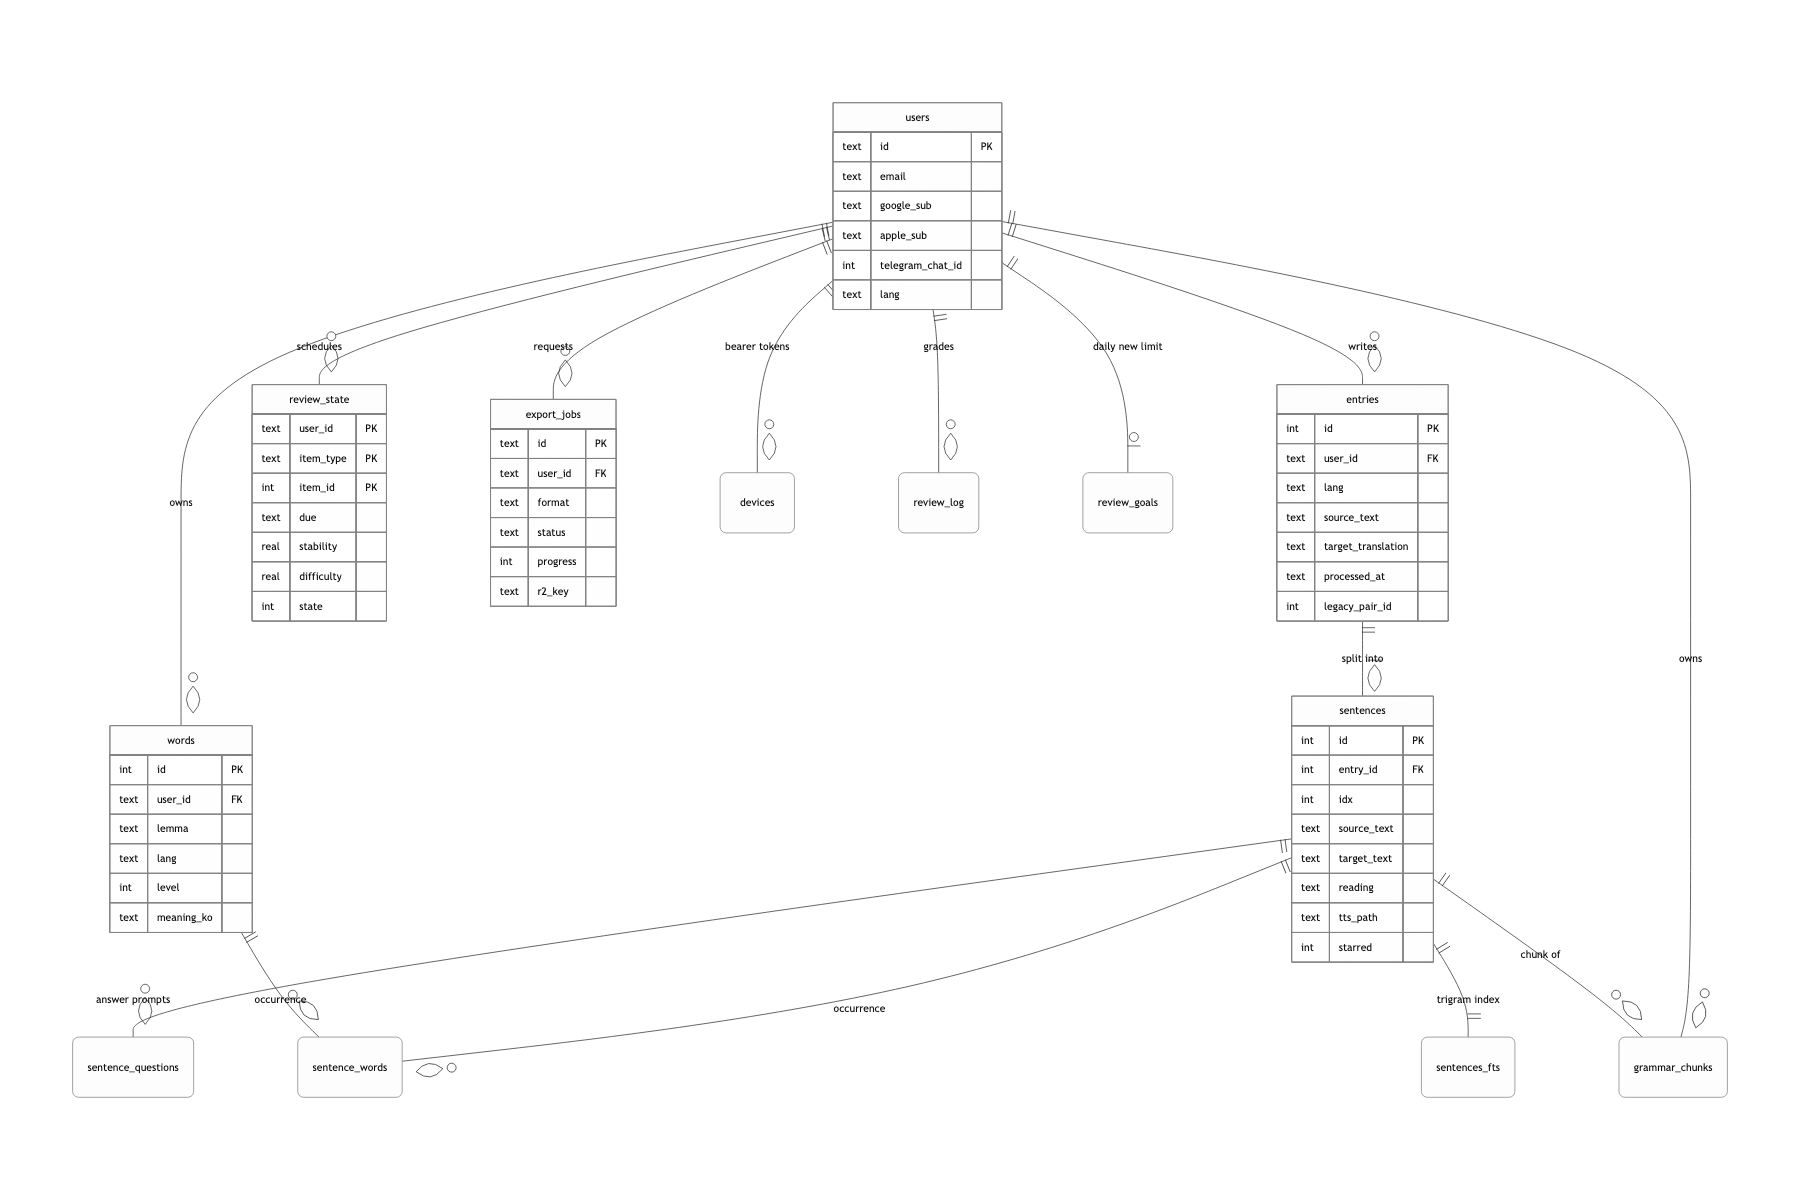
핵심 파이프라인은 runLearningPipeline 한 함수입니다. 한국어 원문을 문장 단위로 쪼개 목표 언어로 번역해 entries와 sentences에 넣고 즉시 반환합니다. 그 뒤 백그라운드에서 문장별 TTS를 R2의 tts/{lang}/s/{id}.mp3에 올리고, 단어와 문법 청크를 뽑아 words·grammar_chunks에 올리고, 문장마다 "이 문장이 답이 되는 질문"을 만들어 sentence_questions에 넣습니다. 앱은 그동안 GET /api/entries/:id를 폴링하며 카드에 오디오 버튼과 질문 줄이 하나씩 붙는 걸 보여줍니다.
Anki 덱을 워커 안에서 통째로 굽기
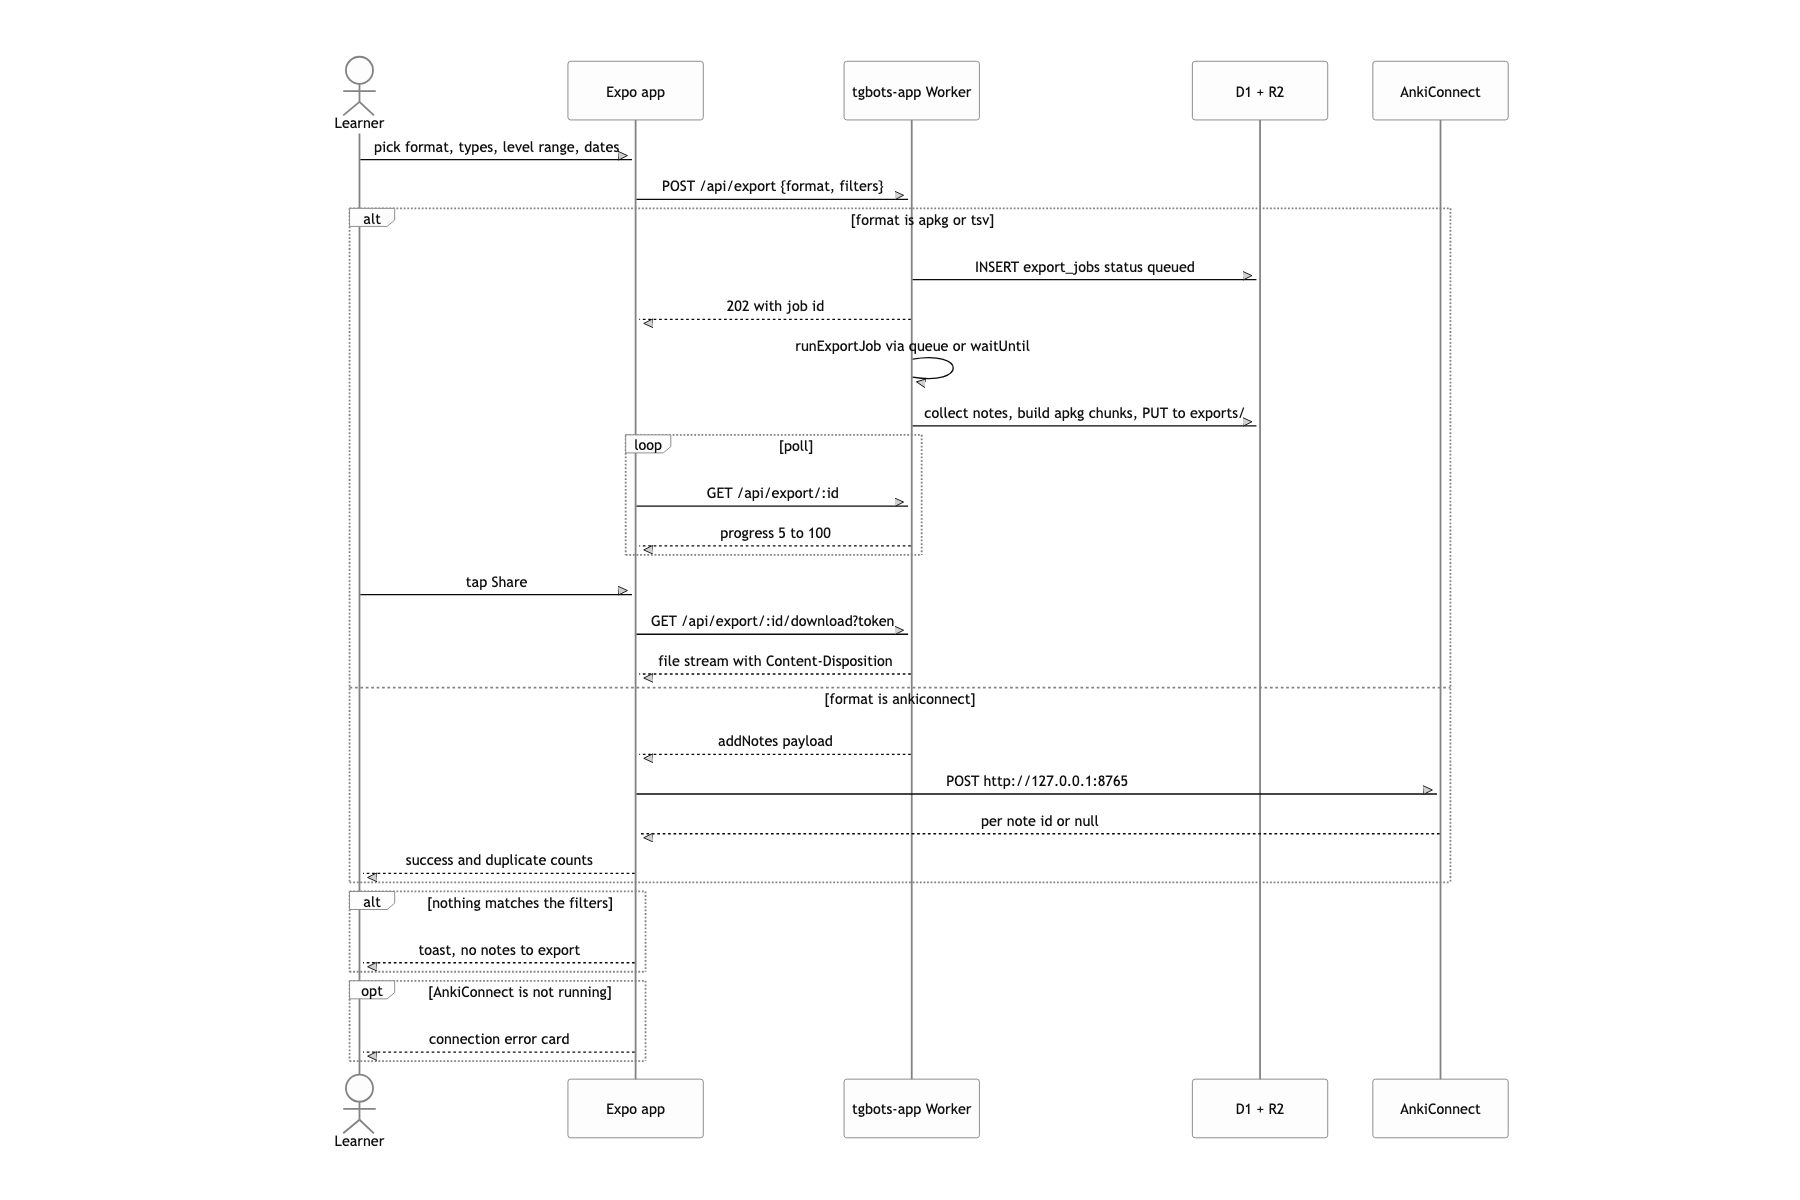
.apkg는 결국 SQLite 파일 하나와 mp3들을 zip으로 묶은 것입니다. 그래서 보통은 Node 서버를 하나 띄우고 genanki 계열 라이브러리에 맡깁니다. 파일시스템에 임시 collection.anki2를 만들고, better-sqlite3로 쓰고, 디렉터리째 zip하는 식이죠. 문제는 이 프로젝트에 그 서버가 없다는 겁니다. Worker 하나 때문에 상주 인스턴스를 세우는 순간 "서버 없이 간다"는 전제가 무너집니다. 그렇다고 TSV만 던져 주고 "오디오는 알아서 넣으세요"라고 하면, 애초에 손품을 줄이려고 만든 시스템이 손품을 되돌려주는 셈이 되고요.
덱 생성을 워커 안으로 가져왔습니다. sql.js를 WASM 모듈로 import하고 initSqlJs의 instantiateWasm 훅에서 그 모듈을 직접 인스턴스화합니다. 여기서 두 군데가 걸렸어요. 하나는 emscripten 글루가 WorkerGlobalScope를 보고 자기가 웹 워커인 줄 알고 self.location.href를 읽는데 workerd에는 location이 없다는 것. 그래서 Object.defineProperty로 무해한 location을 하나 심어 줬습니다. 다른 하나는 Workers가 런타임에 바이트 배열을 컴파일하는 걸 금지한다는 것이고, 이건 훅으로 사전 컴파일된 모듈을 넘겨 피했습니다.
그 위에 schema 11 스키마를 직접 db.run으로 세우고, 노트 GUID를 saiwon:{lang}:{w|s|g}:{id}로 고정했습니다. 노트·카드 id는 GUID에서 FNV 해시로 뽑아 재현 가능하게 만들었고요. 오디오는 R2에서 읽어 zip에 level: 0으로, 즉 무압축으로 넣습니다. 노트가 500개를 넘으면 .apkg를 여러 조각으로 쪼개고 두 개 이상이면 .zip 번들로 묶은 뒤, 결과를 R2 exports/에 올리고 토큰이 붙은 URL로 내려줍니다.
GUID를 고정한 게 제일 컸습니다. Anki는 노트를 GUID로 대조하기 때문에, 두 달 뒤 같은 필터로 다시 내보내도 중복 카드가 쌓이는 대신 기존 카드가 갱신돼요. 사용자가 그 카드에 쌓아 둔 복습 이력이 그대로 살아남습니다.
무압축 zip도 의도한 선택입니다. mp3는 이미 압축돼 있어 다시 눌러 봐야 CPU만 먹고, 비압축 collection.anki2는 구버전 Anki도 그냥 읽습니다. 500노트 청킹은 워커 메모리 한도를 넘기지 않으려는 안전선이고요. 큐 바인딩이 있으면 소비자에서, 없으면 waitUntil로 요청 뒤에 이어 도는 구조라 유료 플랜 없이도 같은 코드가 굴러갑니다.
2개 국어로 쌓인 데이터를 8개 언어 스키마로 갈아엎기
entries에 ru_translation과 jp_translation이 나란히 있는 2개 국어 전용 스키마였고, 언어를 8개로 늘리려면 한 행에 한 언어 구조로 바꿔야 했습니다.
마이그레이션 0021 한 파일 안에서 PRAGMA defer_foreign_keys로 FK 검사를 미루고, 자식 행을 _mig_ 임시 테이블에 파킹한 뒤 부모 테이블을 다시 세우고 되돌려 넣었습니다.
복습 이력을 한 줄도 버리지 않고 8개 언어 스키마로 넘어갔습니다. 지연 FK와 자식 파킹을 어떻게 조합했는지는 그 자체로 한 편이 나오는 이야기라 여기서는 결과만 적습니다.
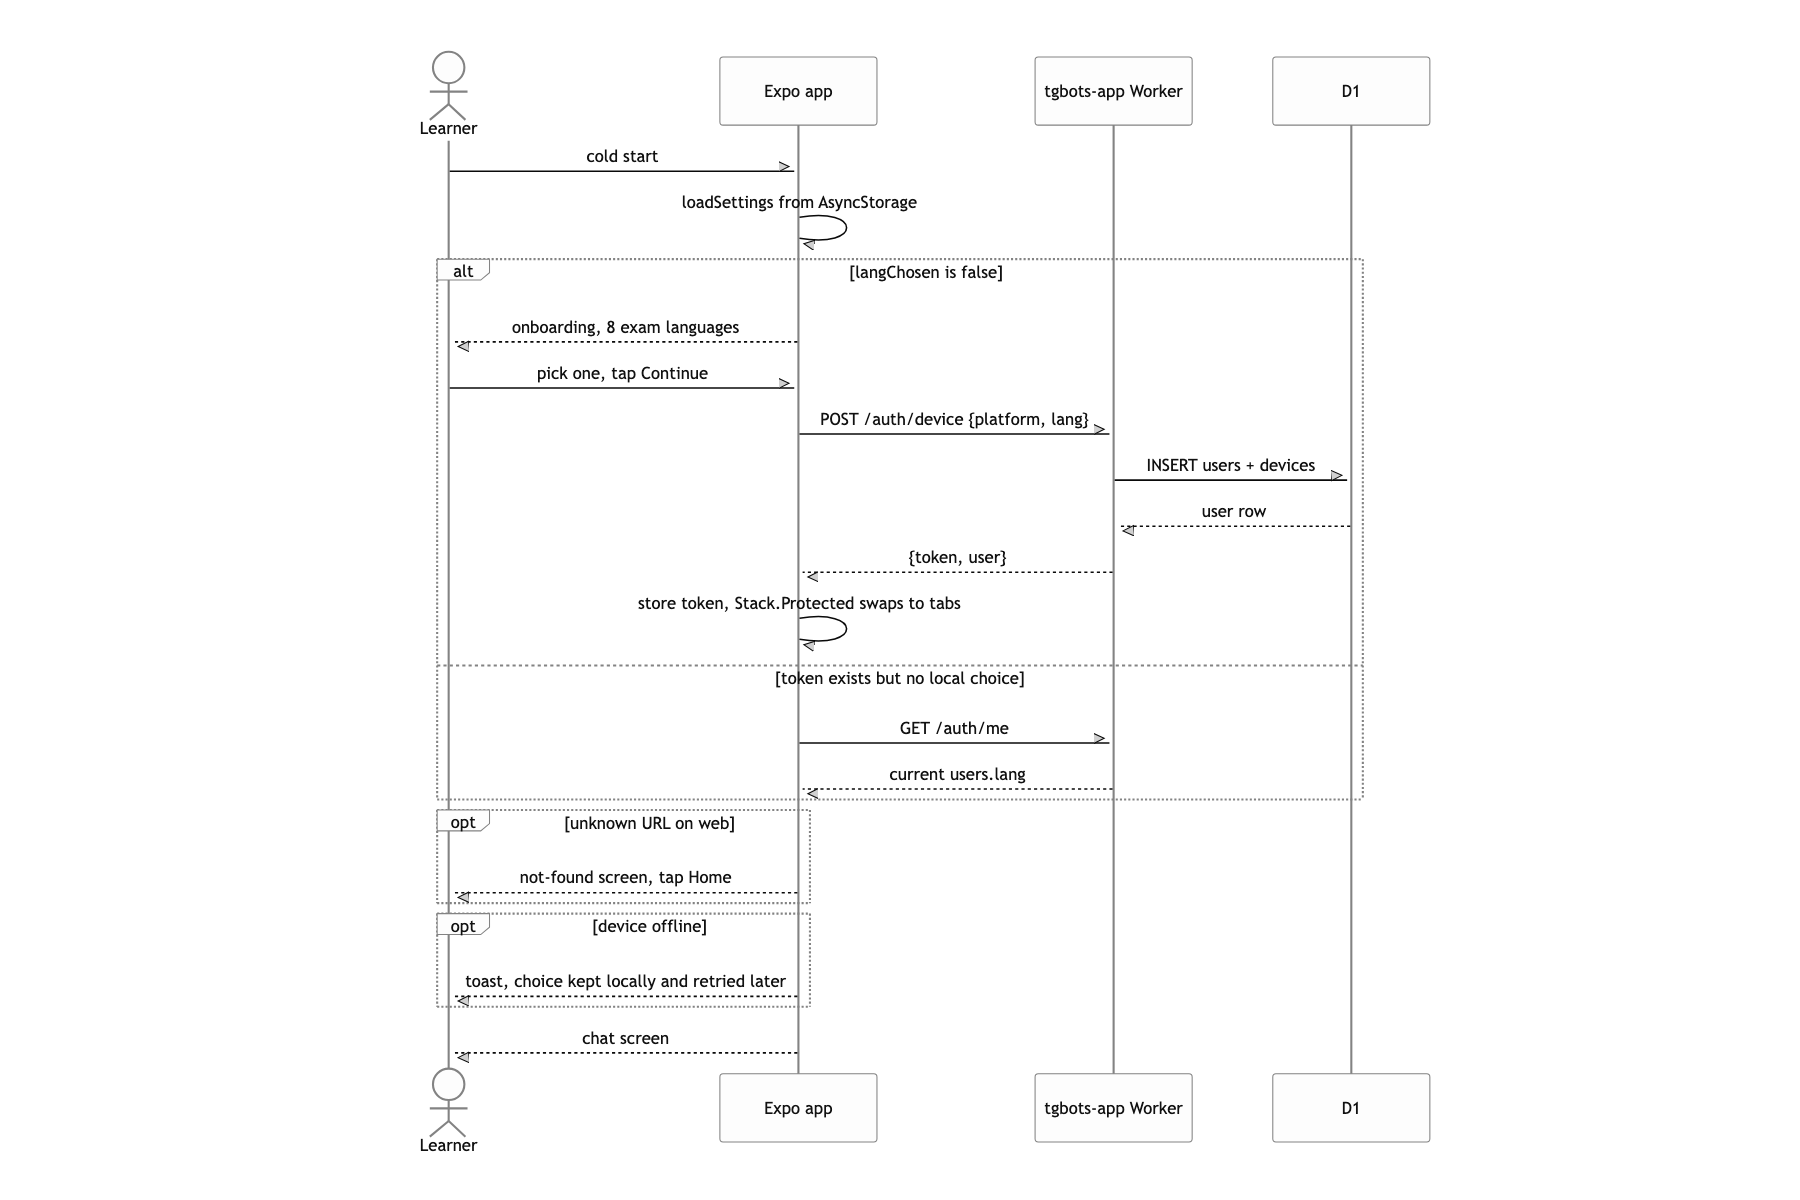
유저가 할 수 있는 일
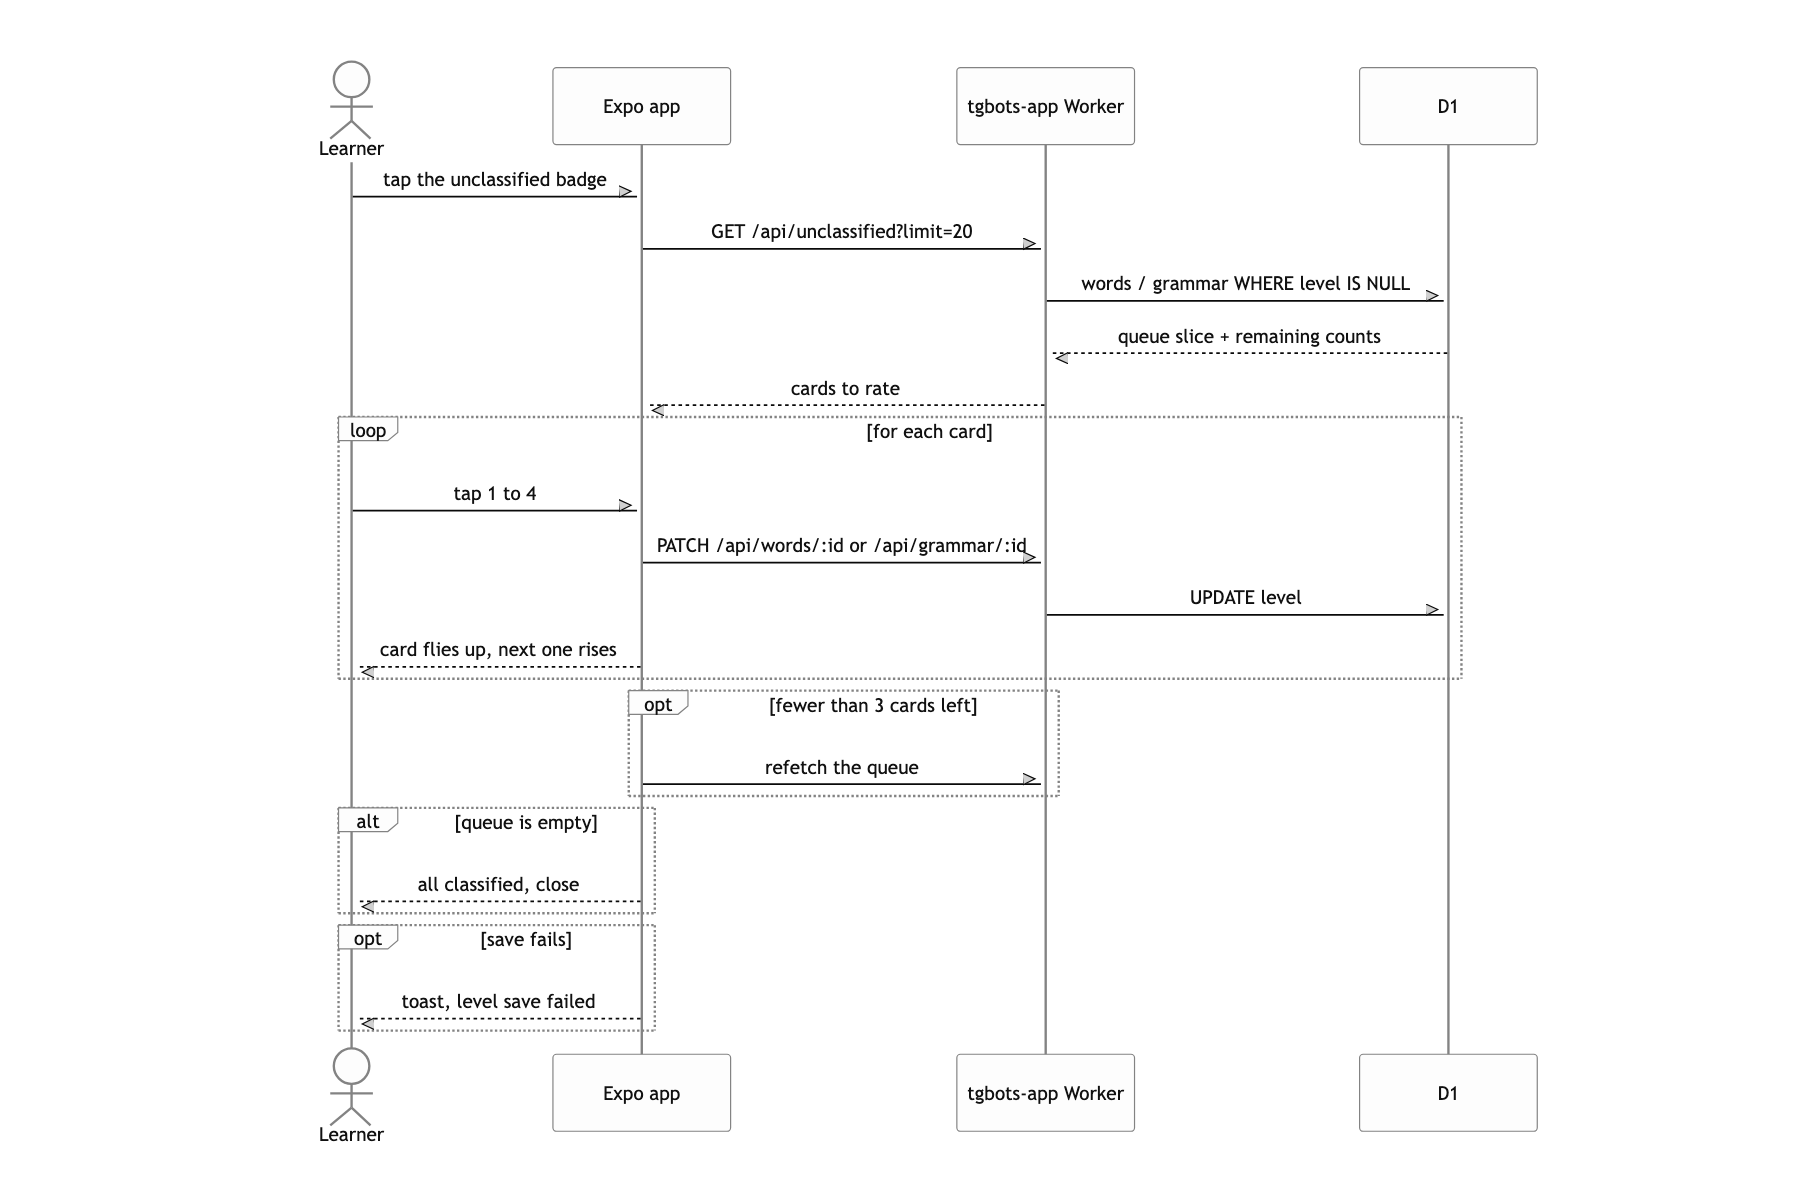
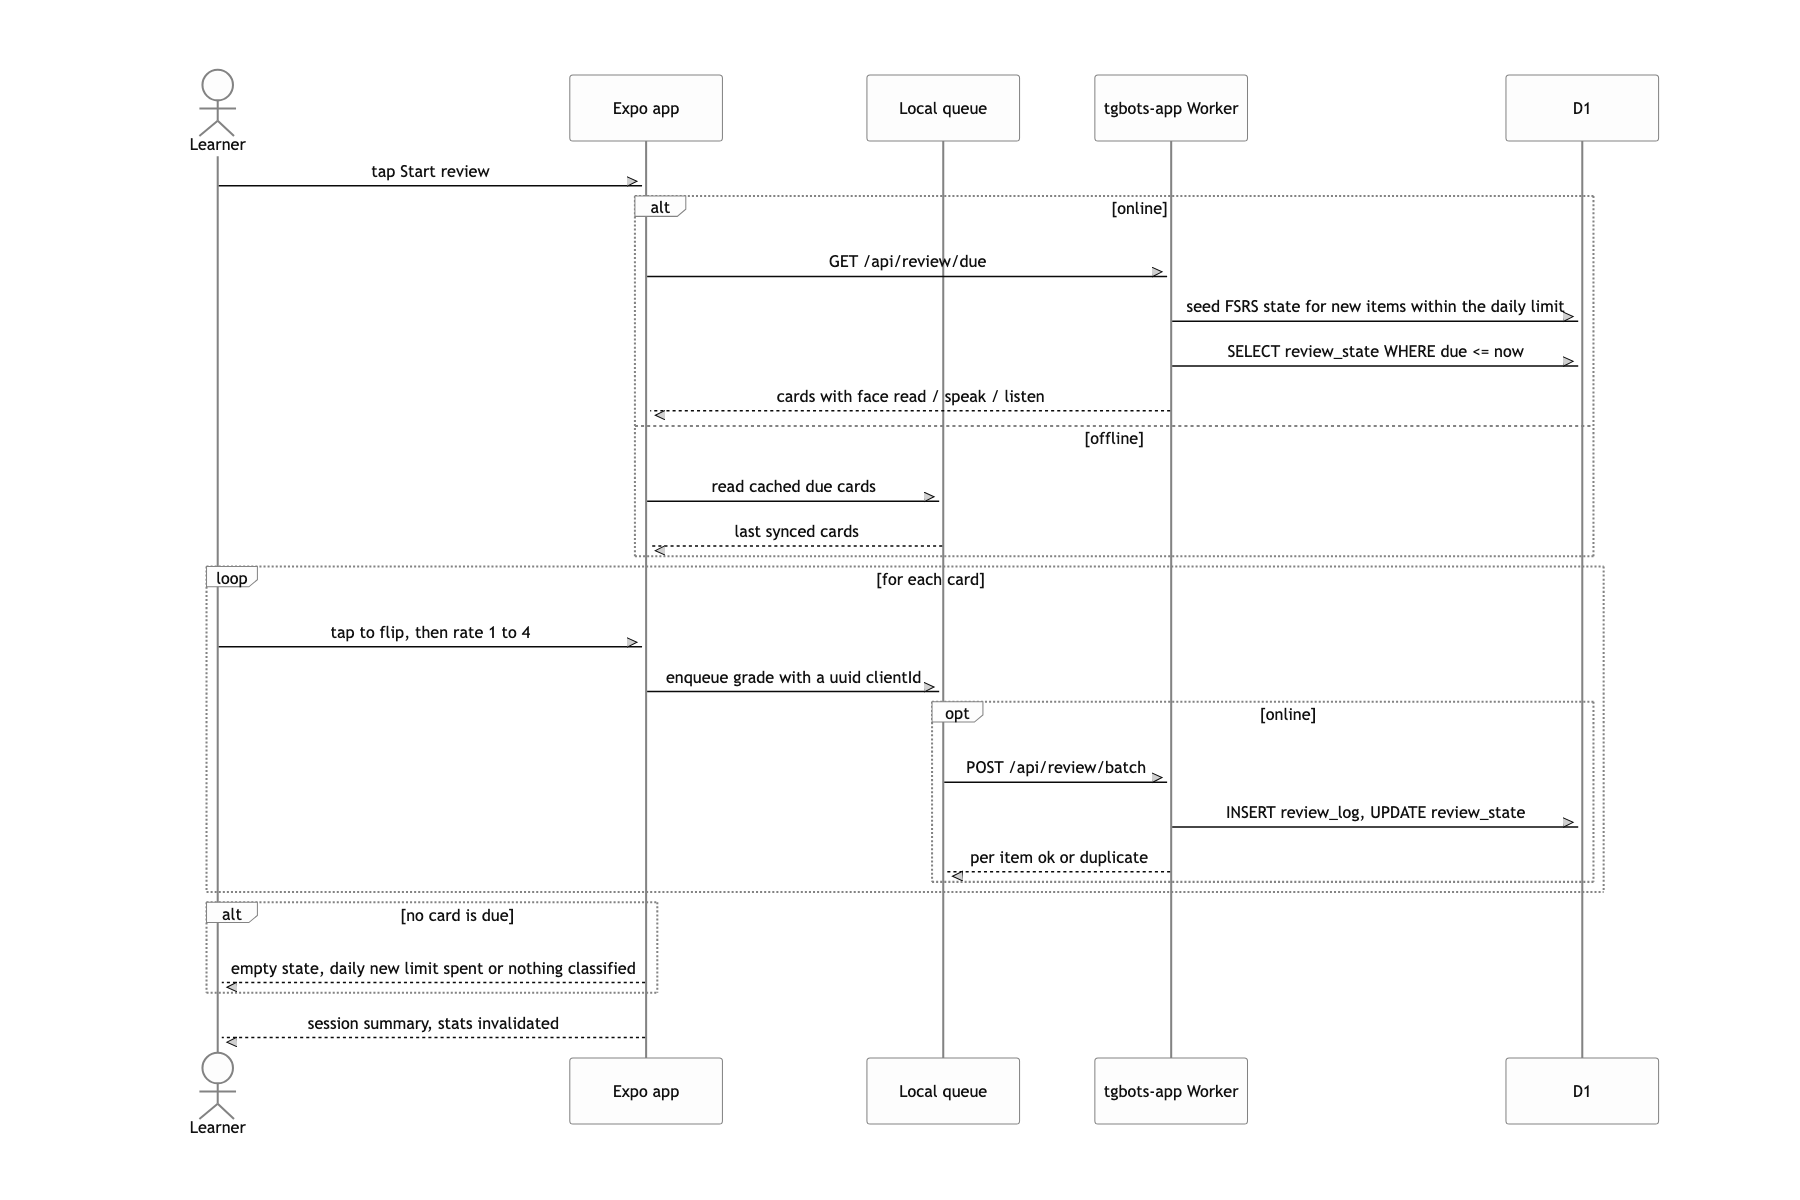
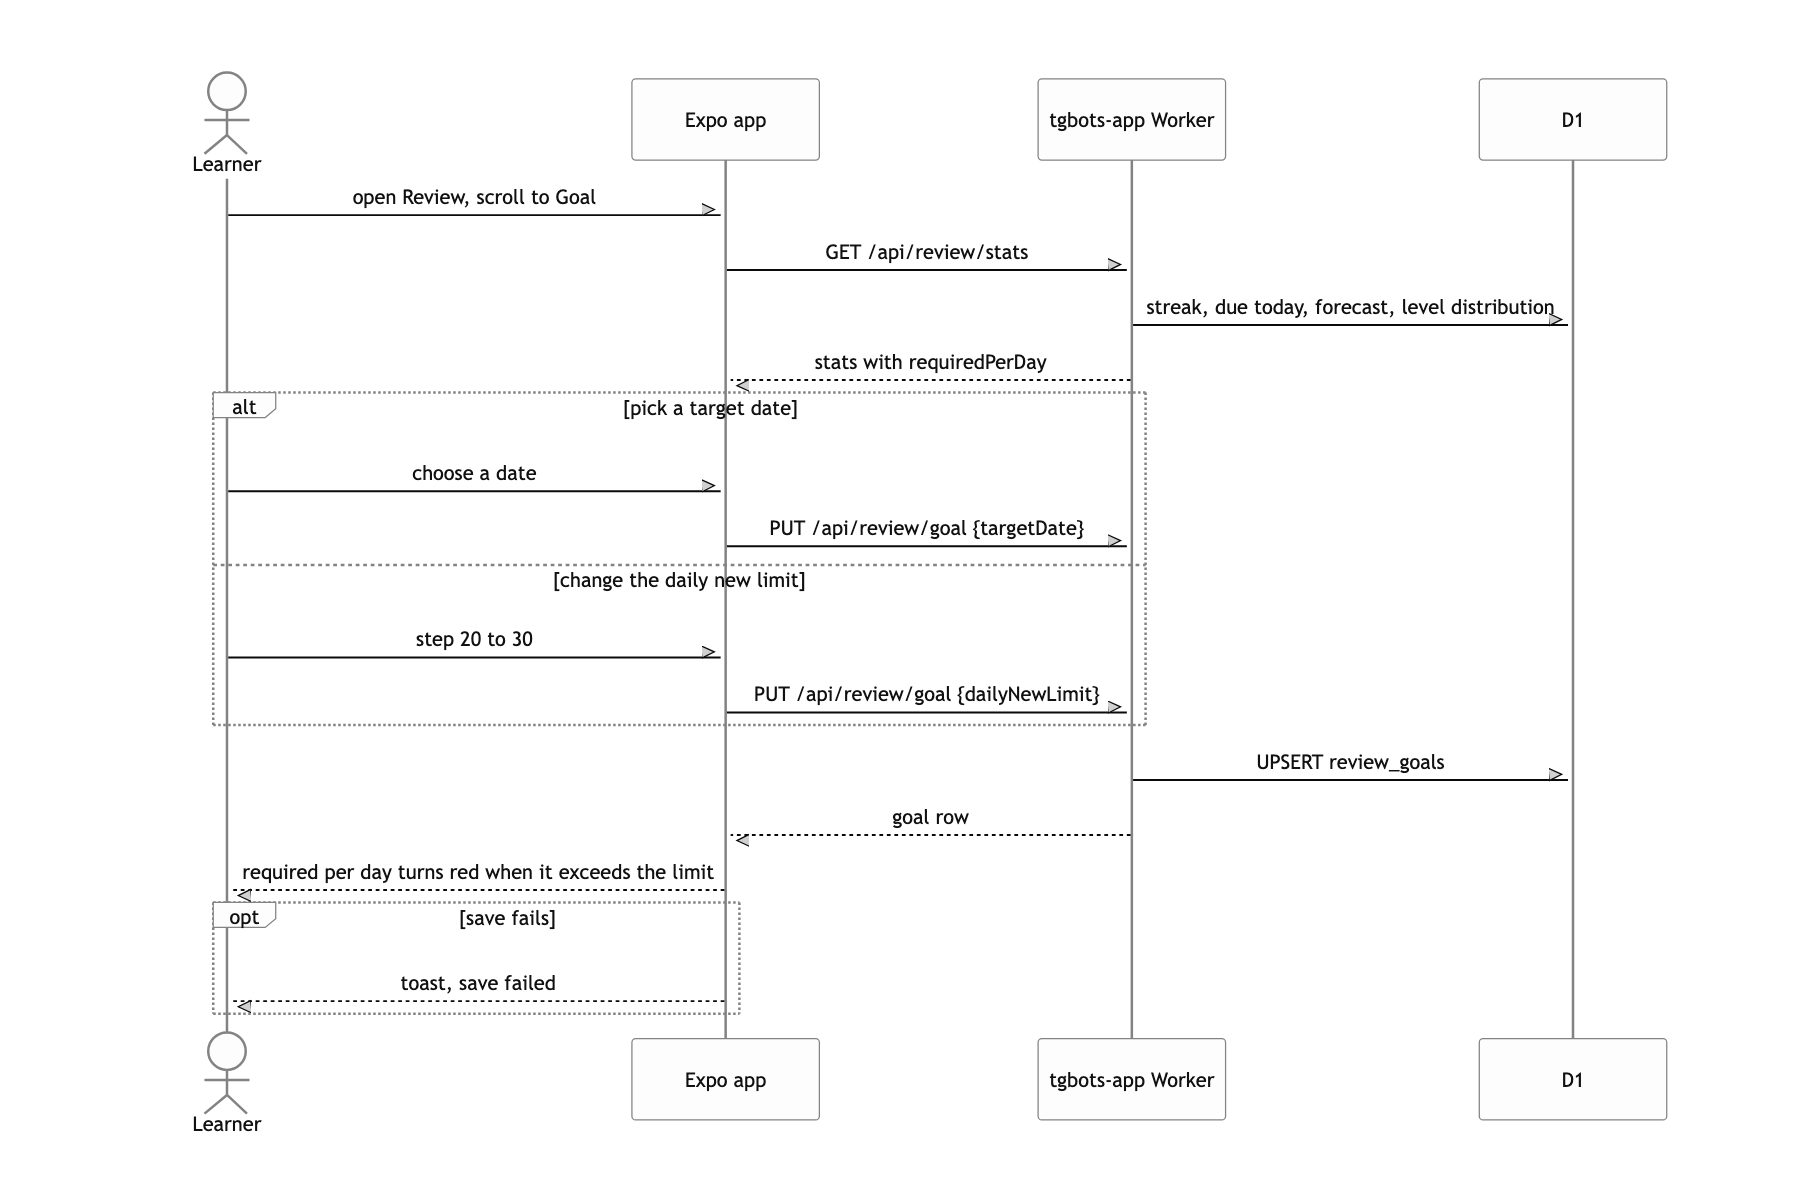
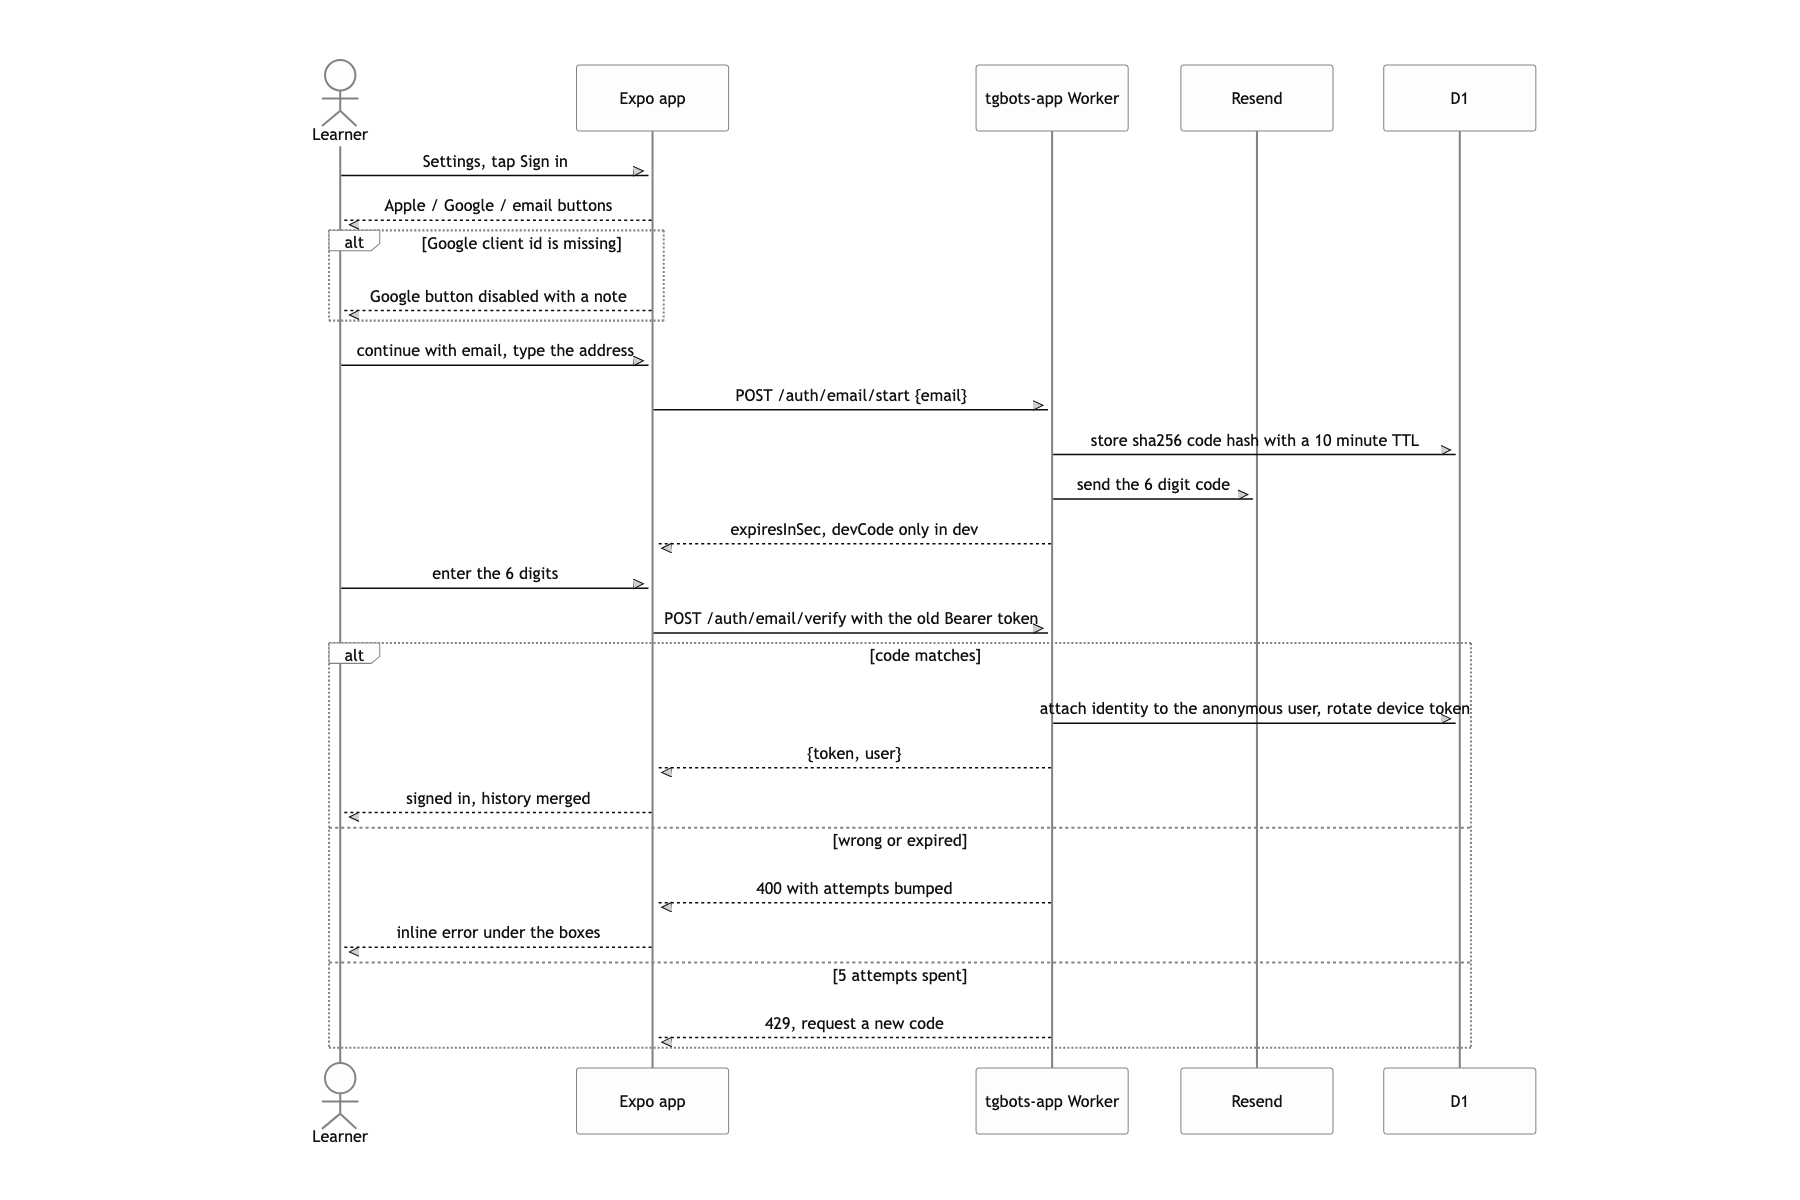
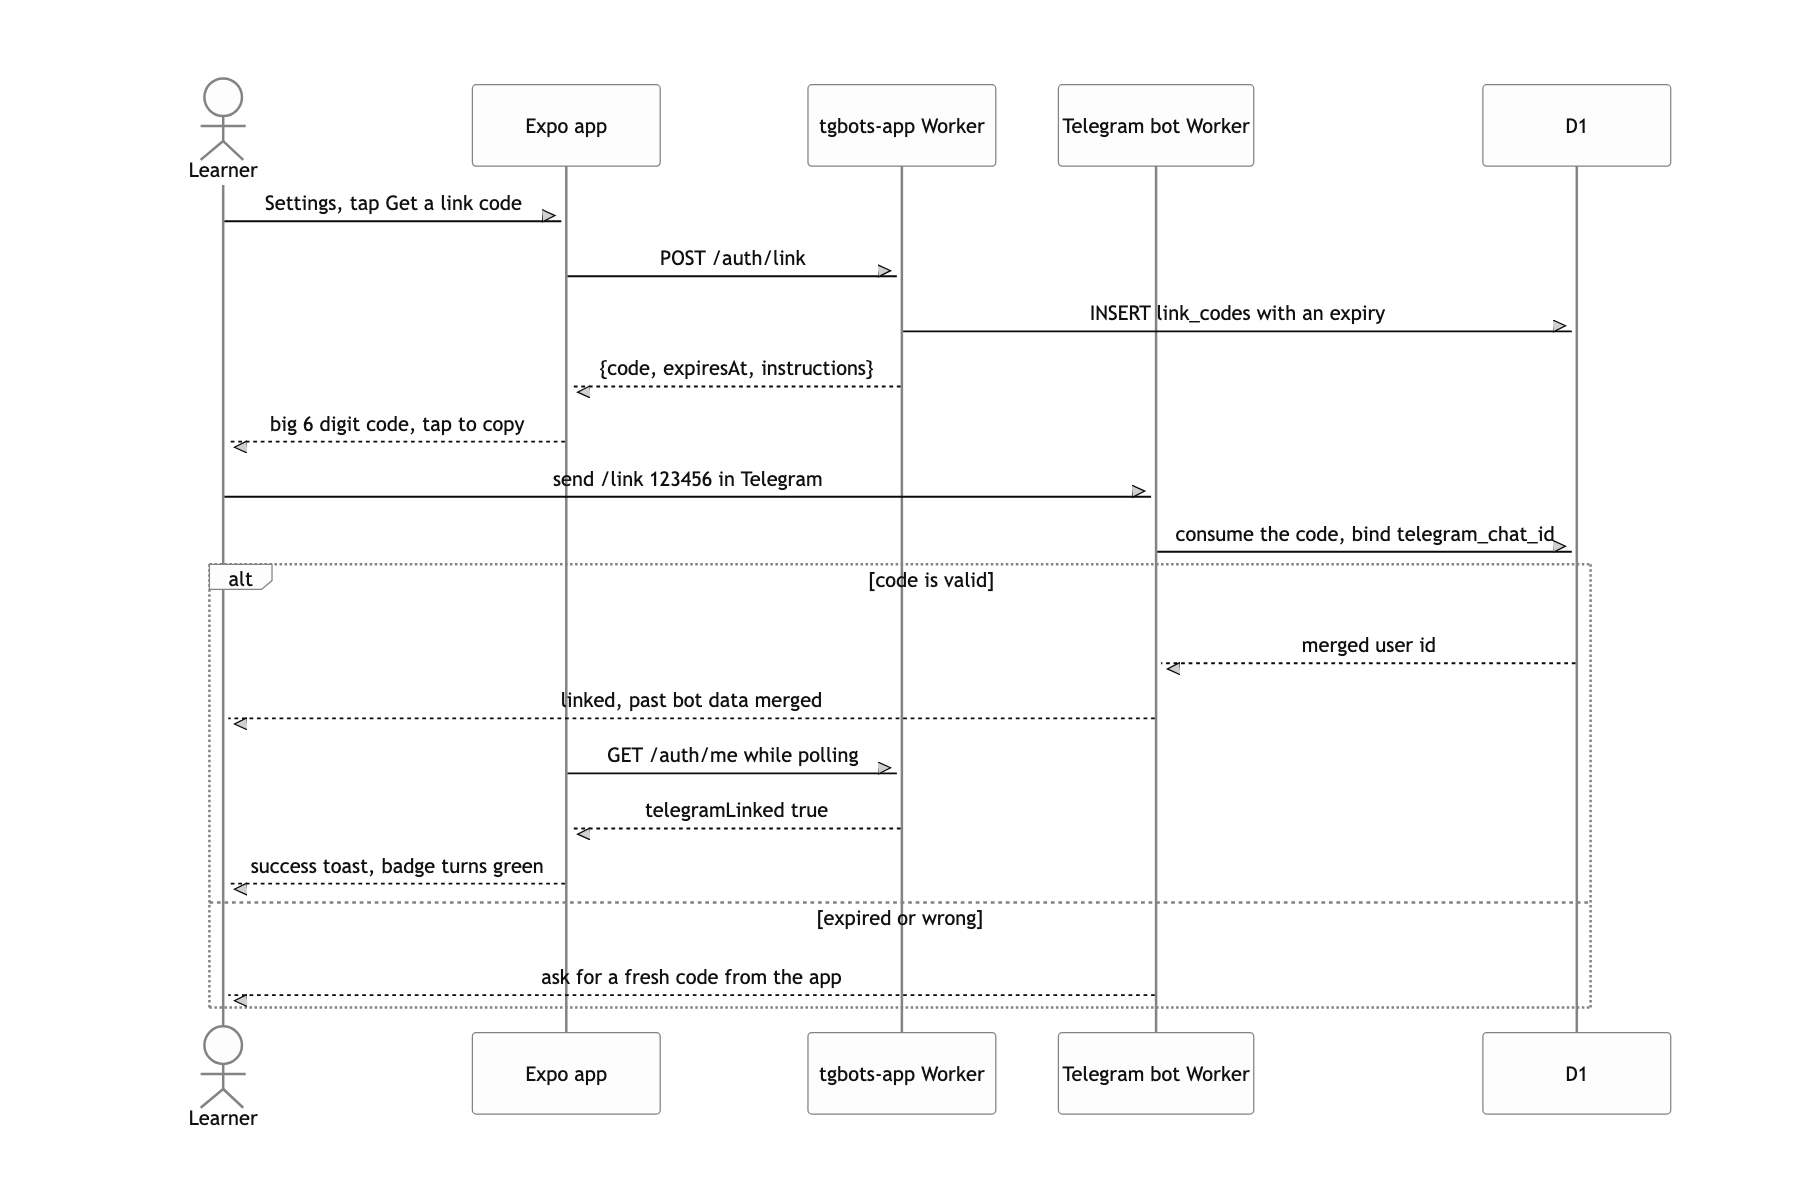
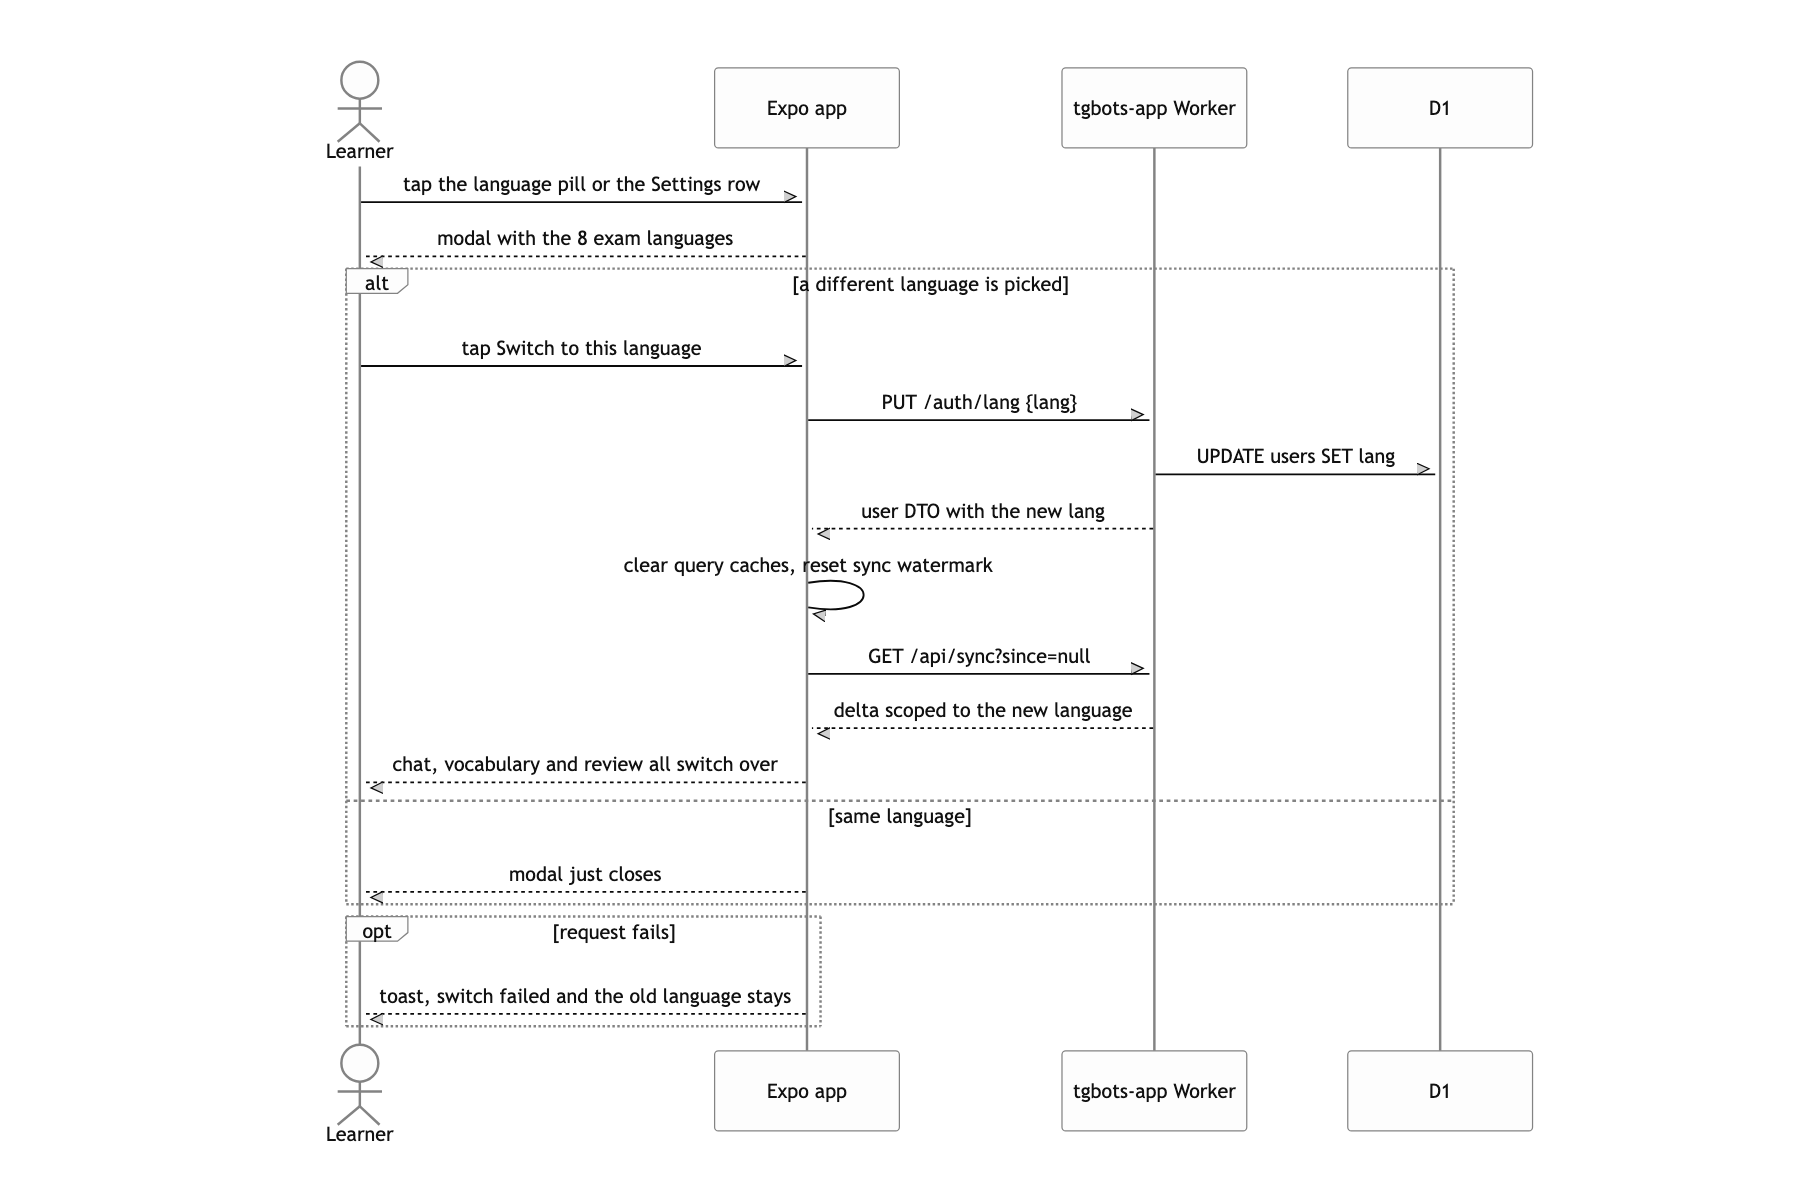
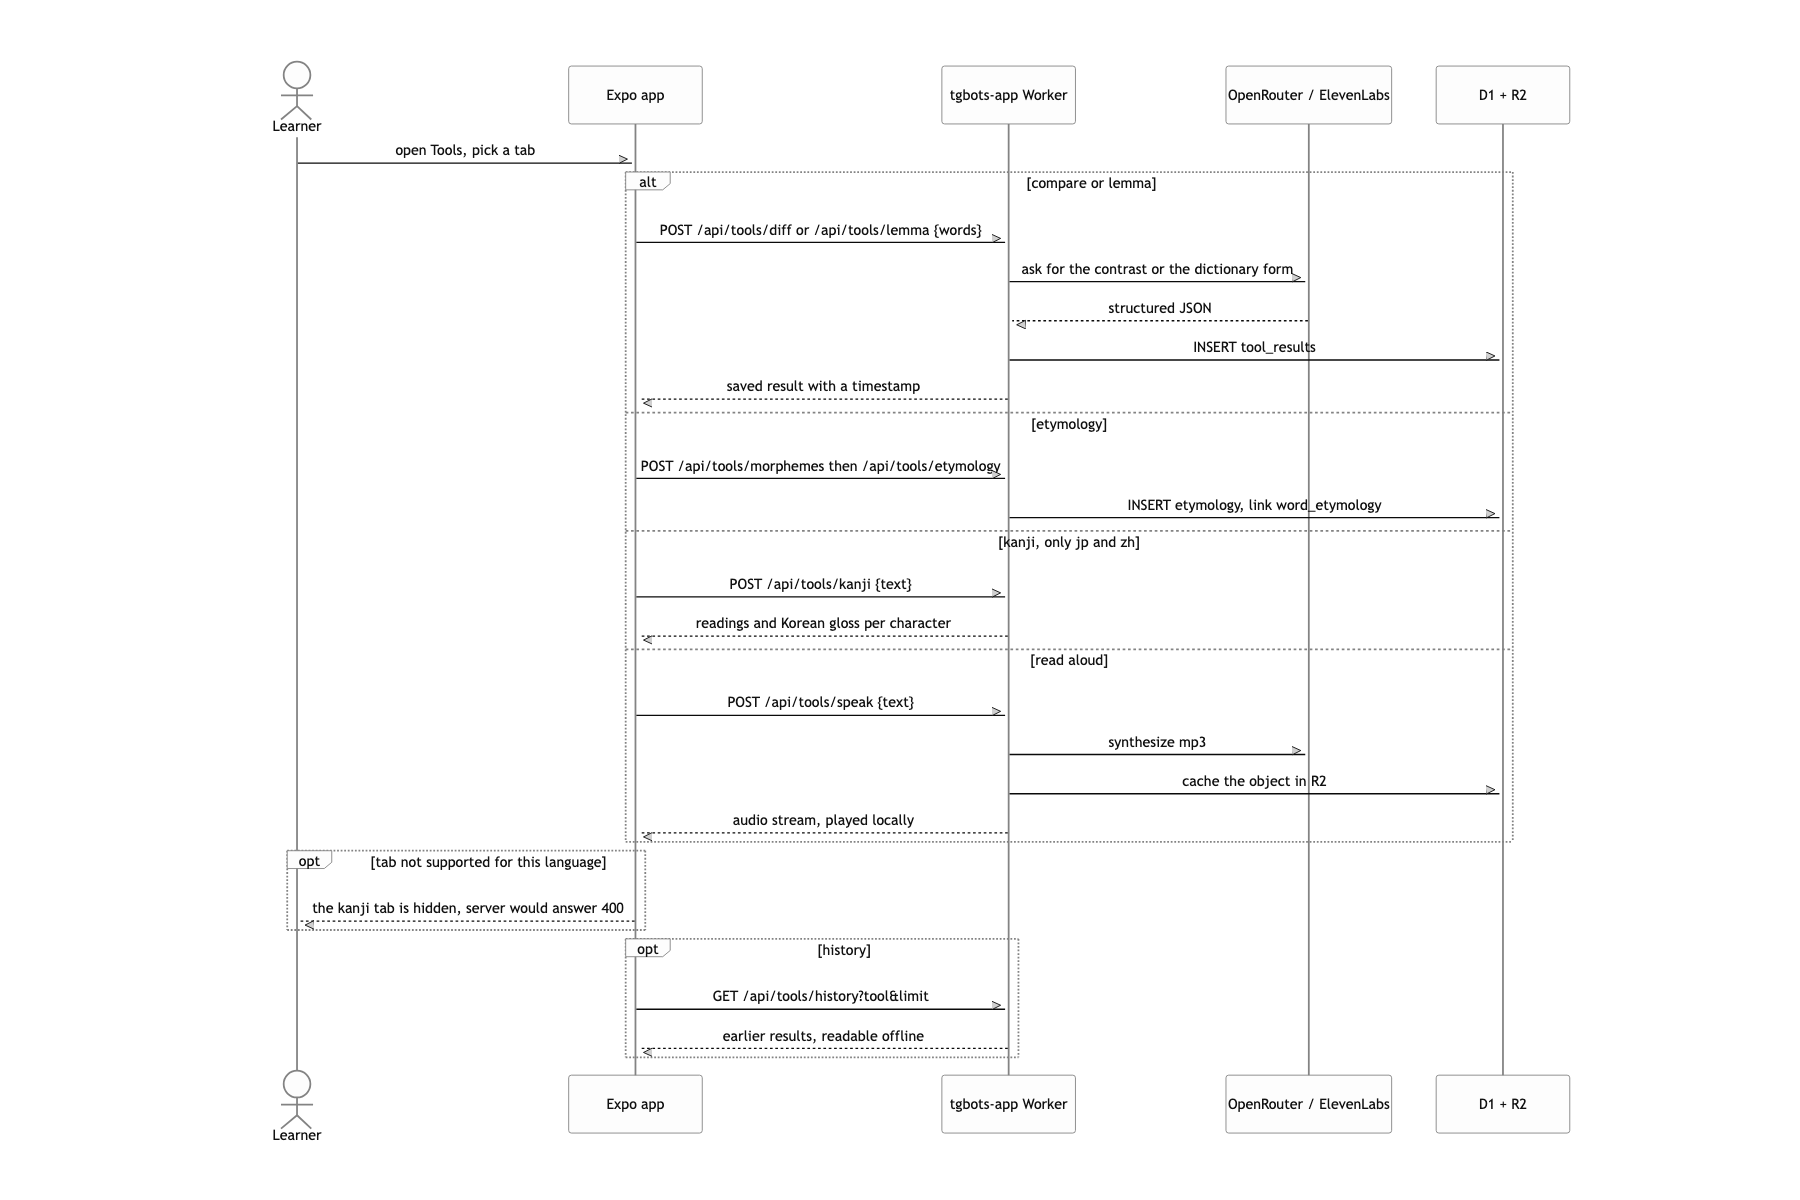
테스트 0줄과 감으로 정한 청크 500
테스트가 한 줄도 없습니다. pnpm typecheck와 eslint가 전부예요. 특히 마이그레이션 0021처럼 되돌릴 수 없는 작업은 로컬 D1 사본에 몇 번 돌려 보고 눈으로 확인한 게 검증의 전부였습니다. 지금 다시 한다면 최소한 스냅샷 하나를 픽스처로 두고 마이그레이션 전후 행 수와 참조 무결성을 자동으로 대조했을 거예요.
EXPORT_CHUNK_SIZE = 500도 솔직히 측정값이 아니라 감입니다. 워커 메모리를 넘기지 않을 것 같은 선을 잡은 것이고, 노트에 붙는 오디오 크기에 따라 실제 안전선은 달라집니다. sql.js가 컬렉션 전체를 메모리에 들고 있는 구조라 여기가 이 시스템에서 가장 먼저 깨질 지점이에요. Queues 바인딩은 코드에 준비해 두고도 wrangler.toml에서는 주석 처리한 상태라, 지금은 큰 내보내기도 waitUntil로 요청 뒤에 매달려 돕니다.
마지막으로 언어 8개 중 프롬프트와 음성을 제대로 다듬은 건 러시아어·일본어·중국어 정도입니다. 나머지 다섯은 같은 파이프라인을 타긴 하지만 발음 표기 규칙이나 보이스가 기본값 그대로예요. 모든 걸 아름답게 다듬어 두지는 못했지만, 적어도 어디가 얇은지는 알고 있습니다.
