원문·번역 동시 표시 영어 강의 자막 플레이어
영어 강의를 원문과 번역을 함께 보며 듣는 자막 도구
영어에 막힌 강의와 느린 외주 자막
영어권 강사의 퀀트 트레이딩 강의를 한국 수강생이 듣는 구조라, 영어 음성을 한국어로 옮기는 자막이 필요했습니다.
요구는 세 가지였습니다. 첫째, 원문과 번역이 같은 화면에 함께 보여야 합니다. 둘째, 강의 VOD뿐 아니라 자막 트랙이 아예 없는 YouTube 영상이나 라이브 Q&A에서도 같은 방식으로 동작해야 합니다. 셋째, 같은 강의를 여러 번 봐도 번역은 한 번만 수행되어야 합니다.
첫 버전은 강의 VOD 플레이어 하나였지만, 두 번째 요구 때문에 특정 플레이어에 묶이지 않고 어디에나 얹히는 자막 레이어가 되어야 했습니다.
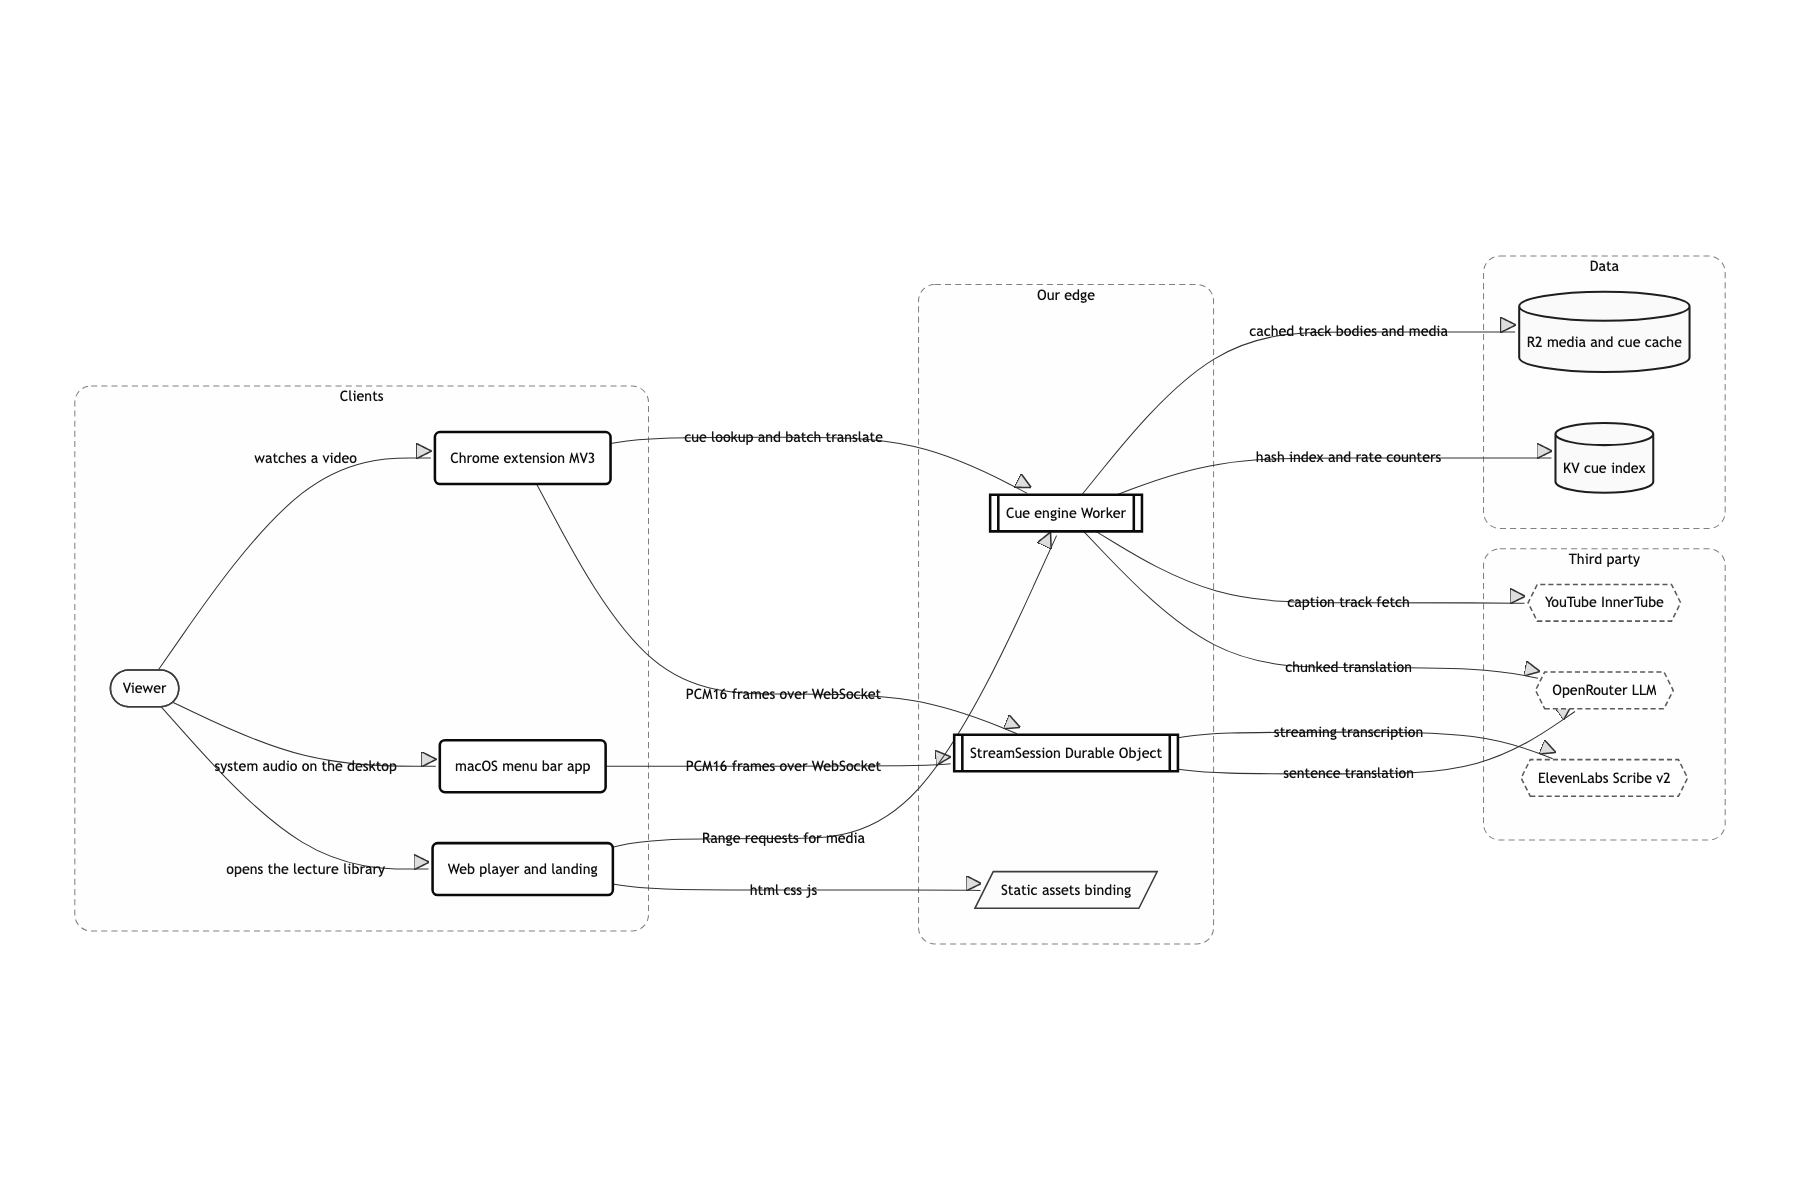
서버는 Worker 하나, 나머지는 클라이언트
실시간 세션을 Durable Object 1개 = 소켓 1개로, hibernation은 끔
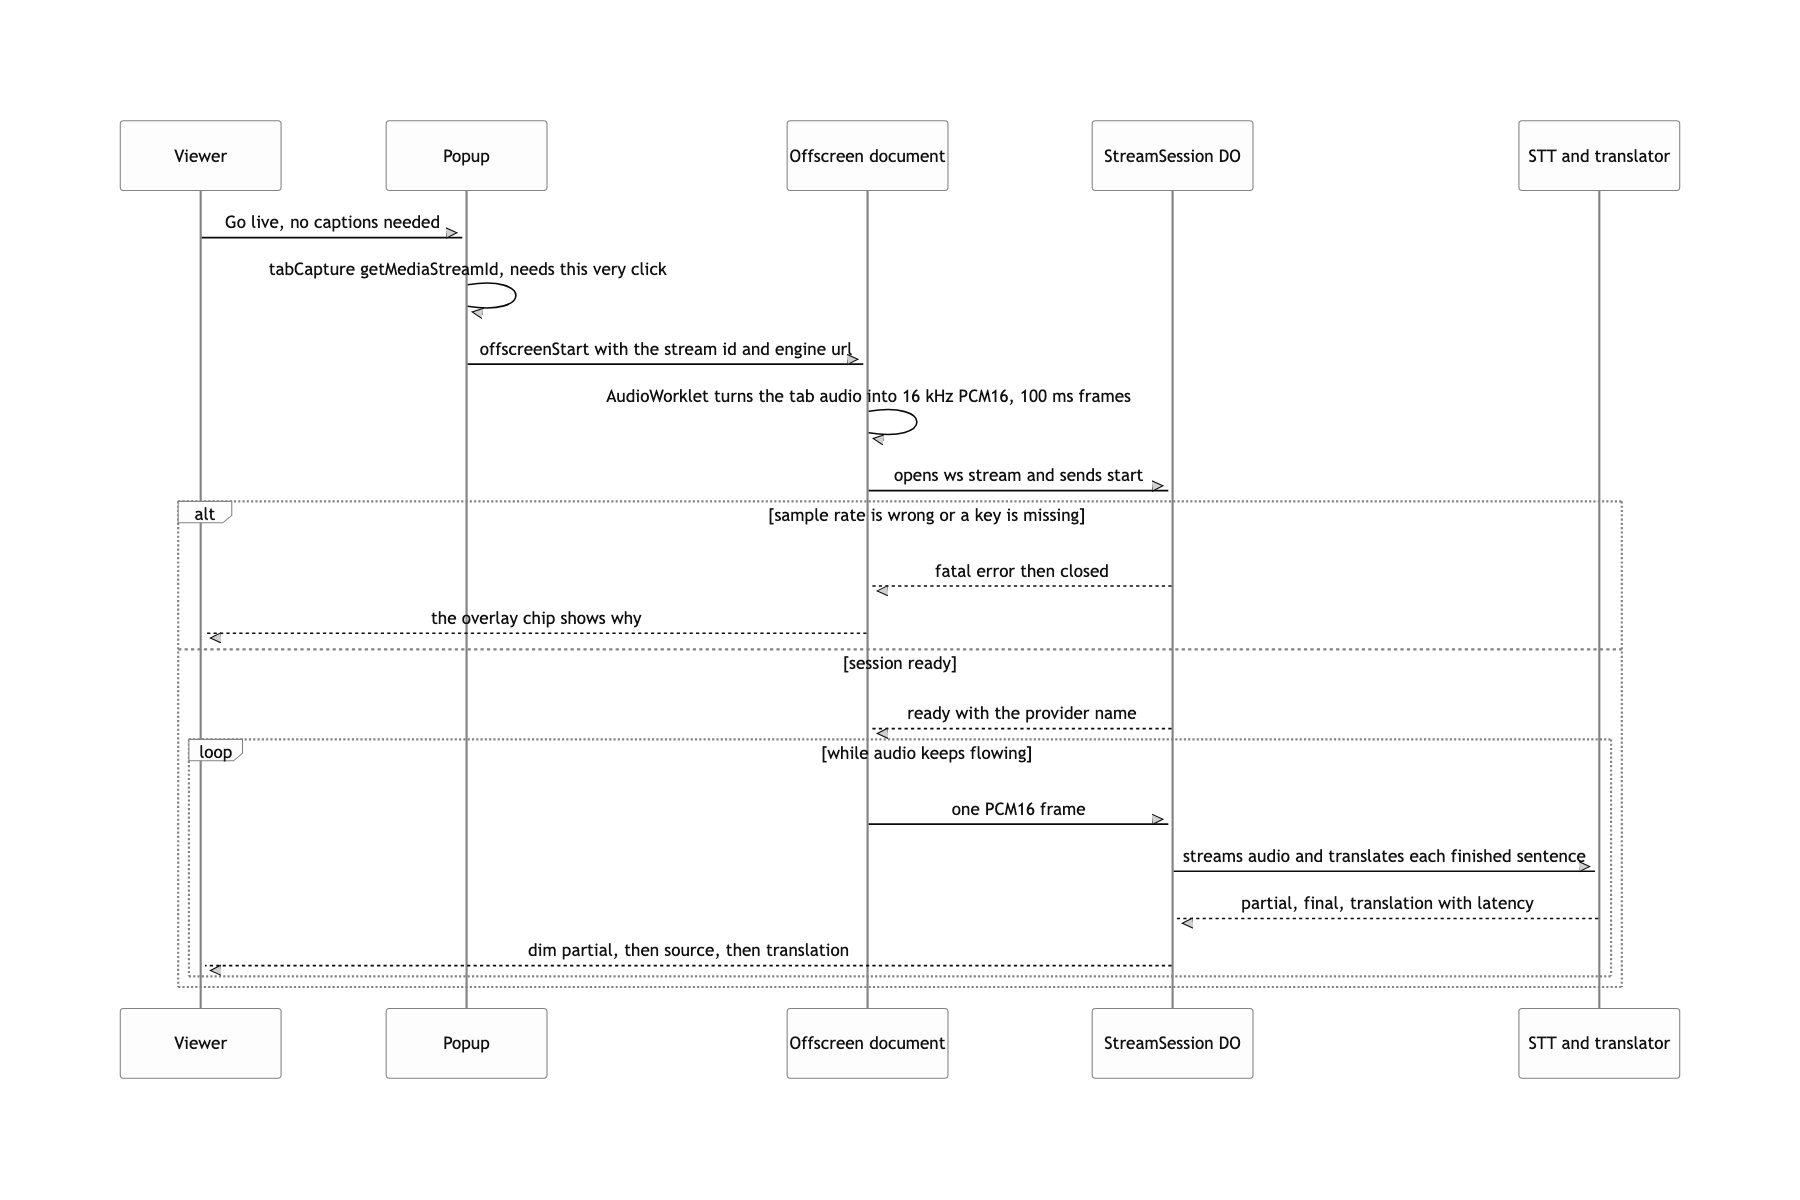
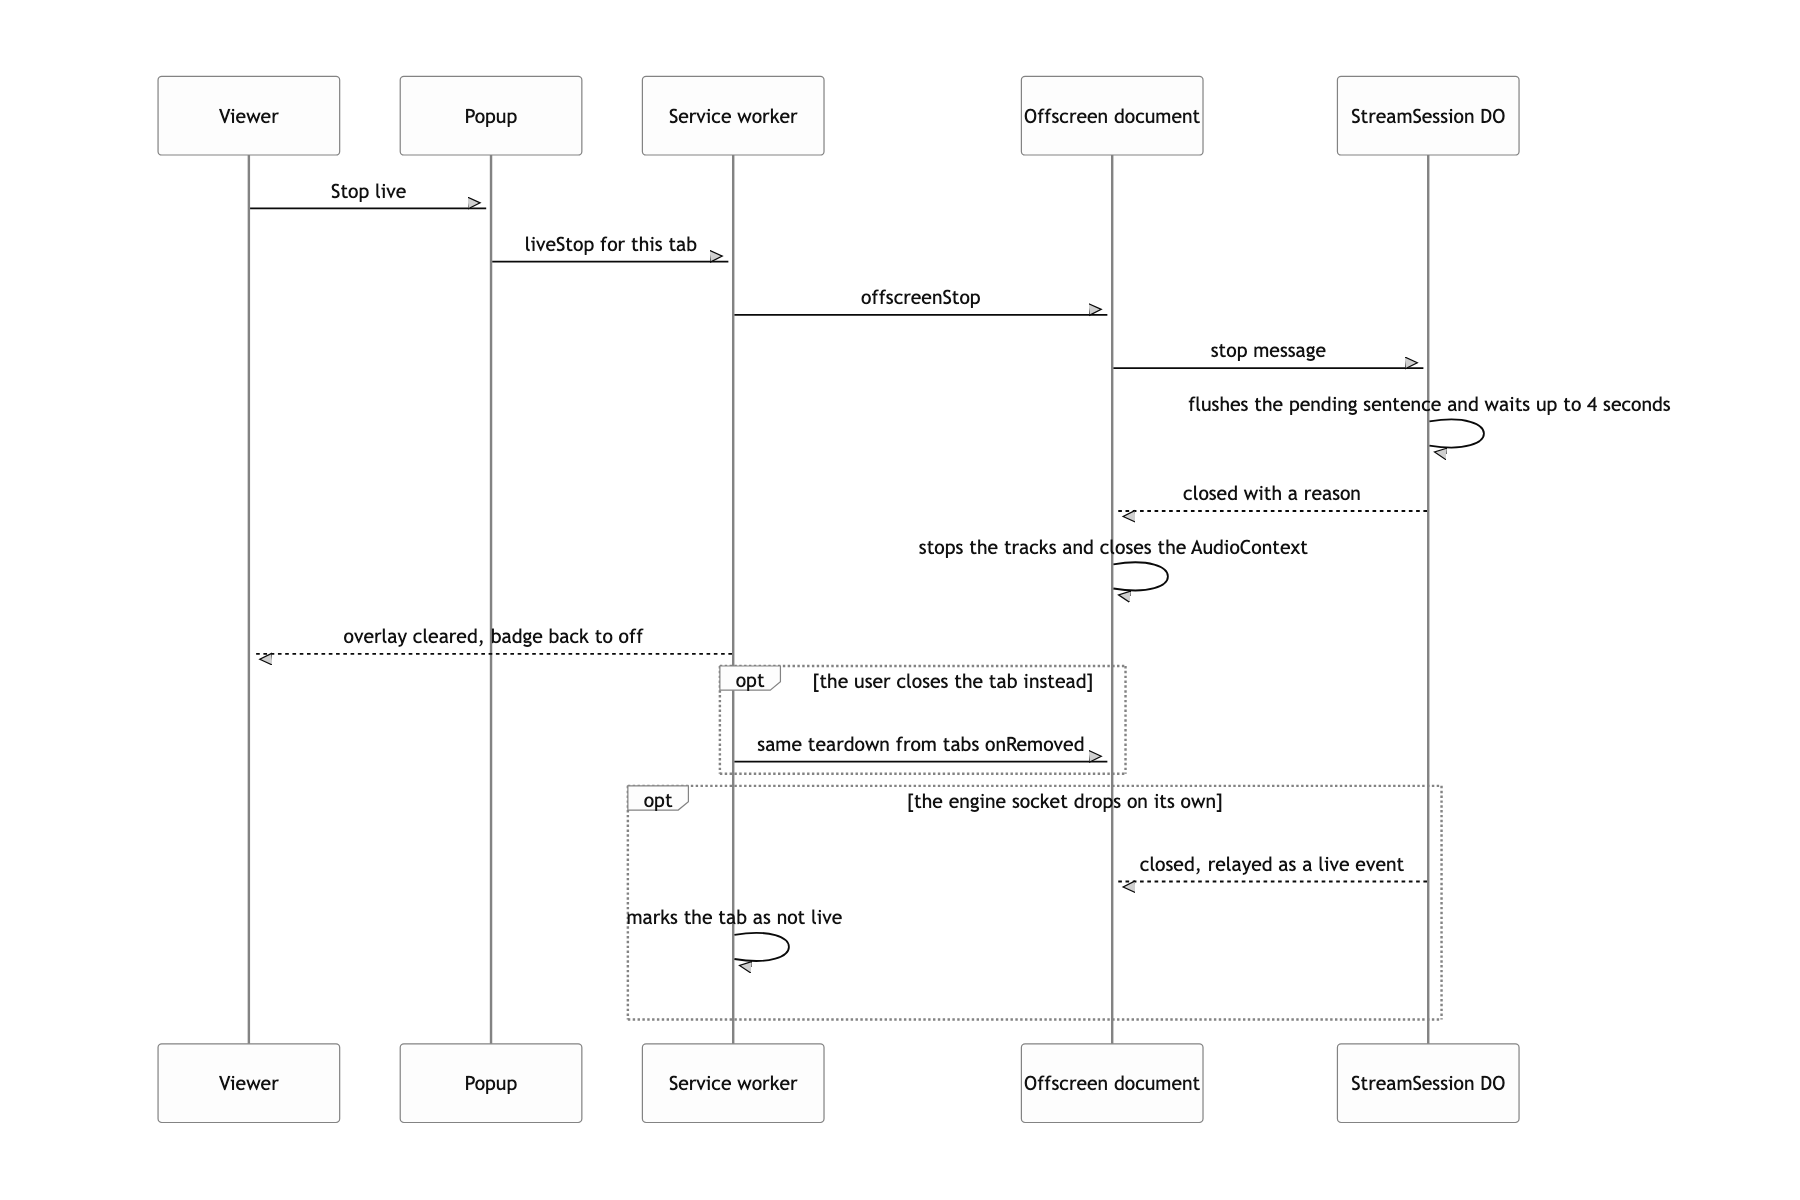
업스트림 STT 소켓이 클라이언트 오디오 프레임 사이에도 계속 열려 있어야 합니다. Worker는 요청 단위로 죽으니 이 상태를 들고 있을 곳이 없고, DO가 그 자리를 정확히 메웠어요. hibernation을 포기하면 세션이 살아 있는 동안 계속 과금됩니다. 대신 newUniqueId() 로 만들어 아무것도 영속하지 않게 했고, stop 이 오면 진행 중인 번역을 최대 4초까지만 기다리고 끊습니다.
STT를 어댑터 인터페이스로 두고 STT_PROVIDER 변수로 교체
실시간 STT는 분기마다 가격과 품질이 바뀝니다. ElevenLabs Scribe v2 Realtime을 기본으로 쓰되 Deepgram과 mock을 같은 connect/onFragment/onError/onClose 계약 뒤에 두면, 어떤 것도 파이프라인 나머지를 건드리지 않고 갈아 끼울 수 있습니다. 키 없이도 파이프라인 전체를 e2e로 돌려야 했기 때문에 mock 어댑터는 선택이 아니라 필수였습니다.
확장의 엔진 호출을 콘텐츠 스크립트가 아니라 백그라운드 서비스 워커에서 수행
콘텐츠 스크립트의 fetch 는 페이지 오리진으로 나갑니다. https인 youtube.com에서 http://127.0.0.1:8787 로 나가는 요청은 Chrome의 로컬 네트워크 접근 규칙에 막혀요. 서비스 워커는 확장의 host permission으로 나가니 이 벽이 없습니다. fetch 시그니처를 그대로 흉내 내는 메시지 왕복 래퍼(engineFetch)를 만들어야 했고, 본문이 문자열인 요청만 지원합니다.
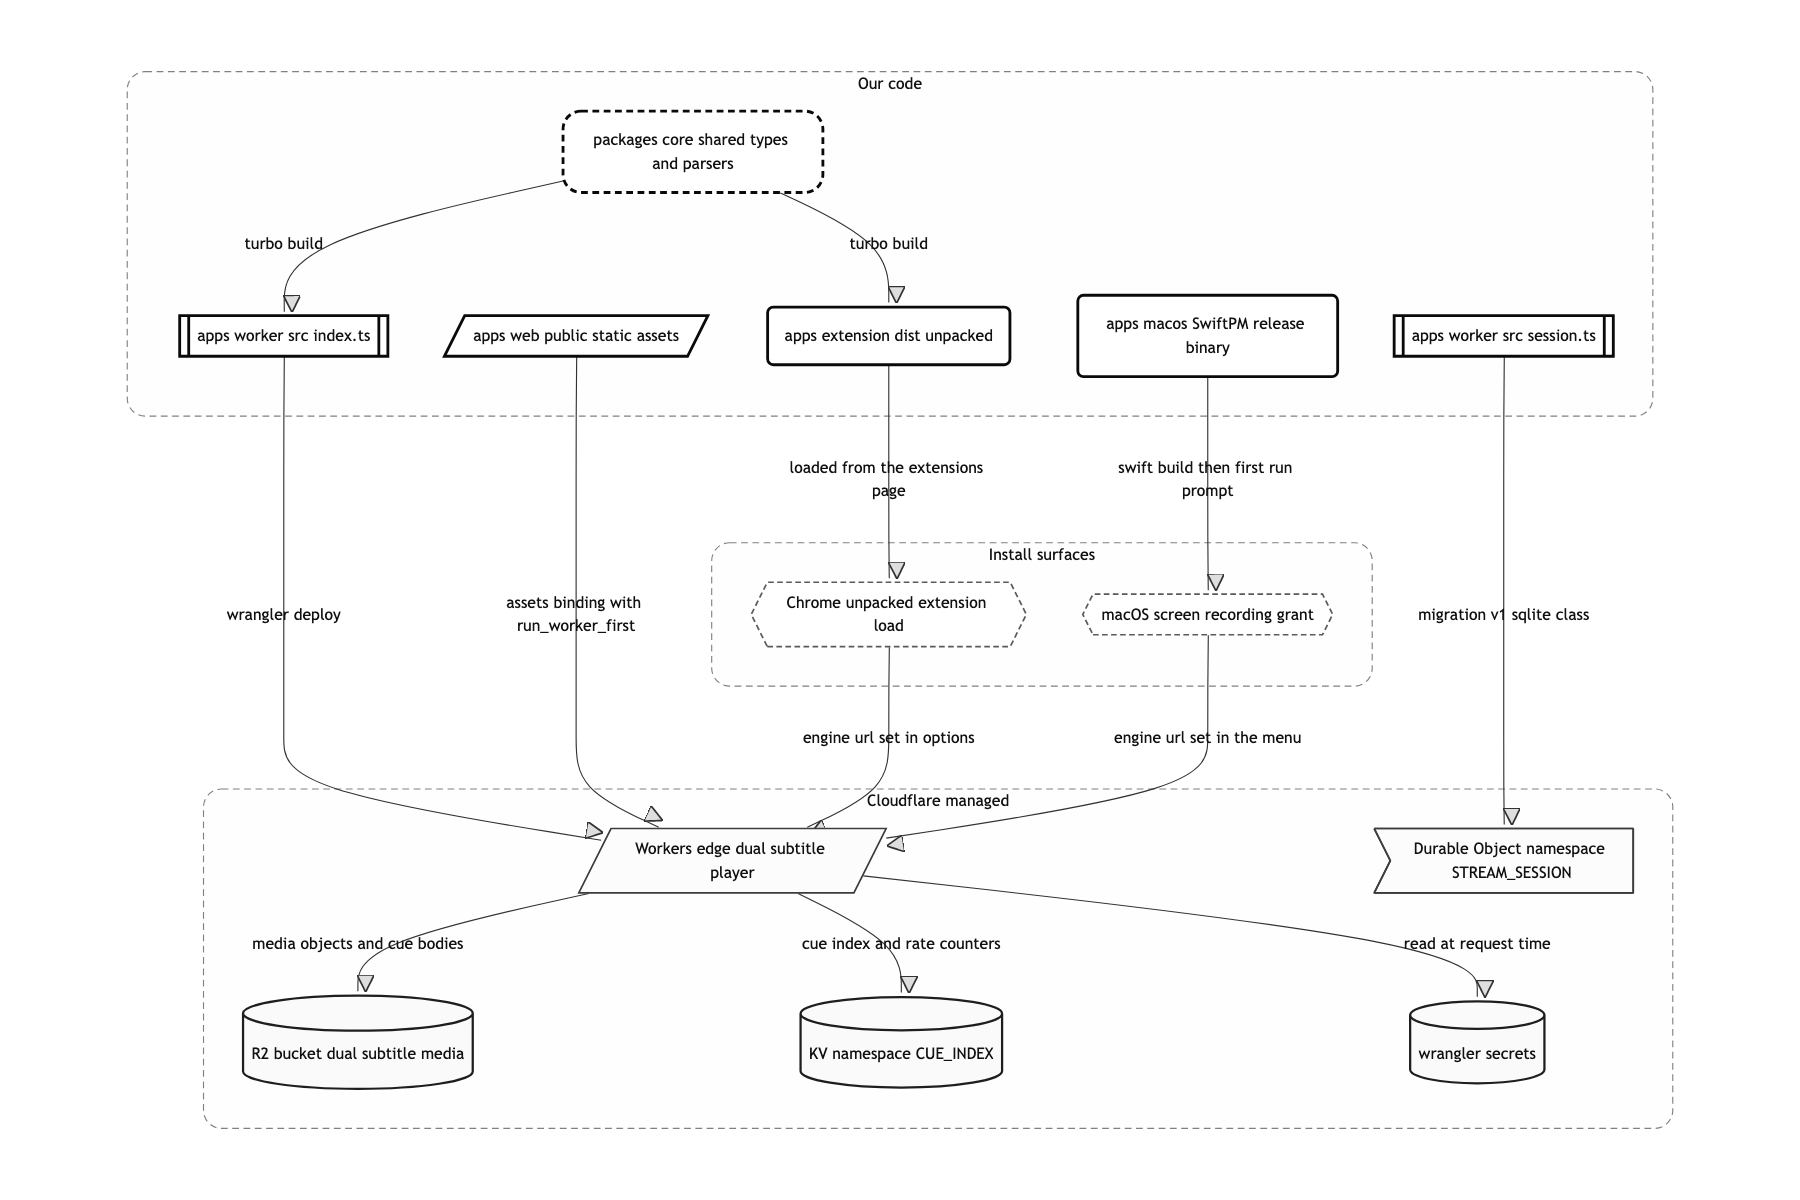
자막이 있으면 읽고 없으면 듣기
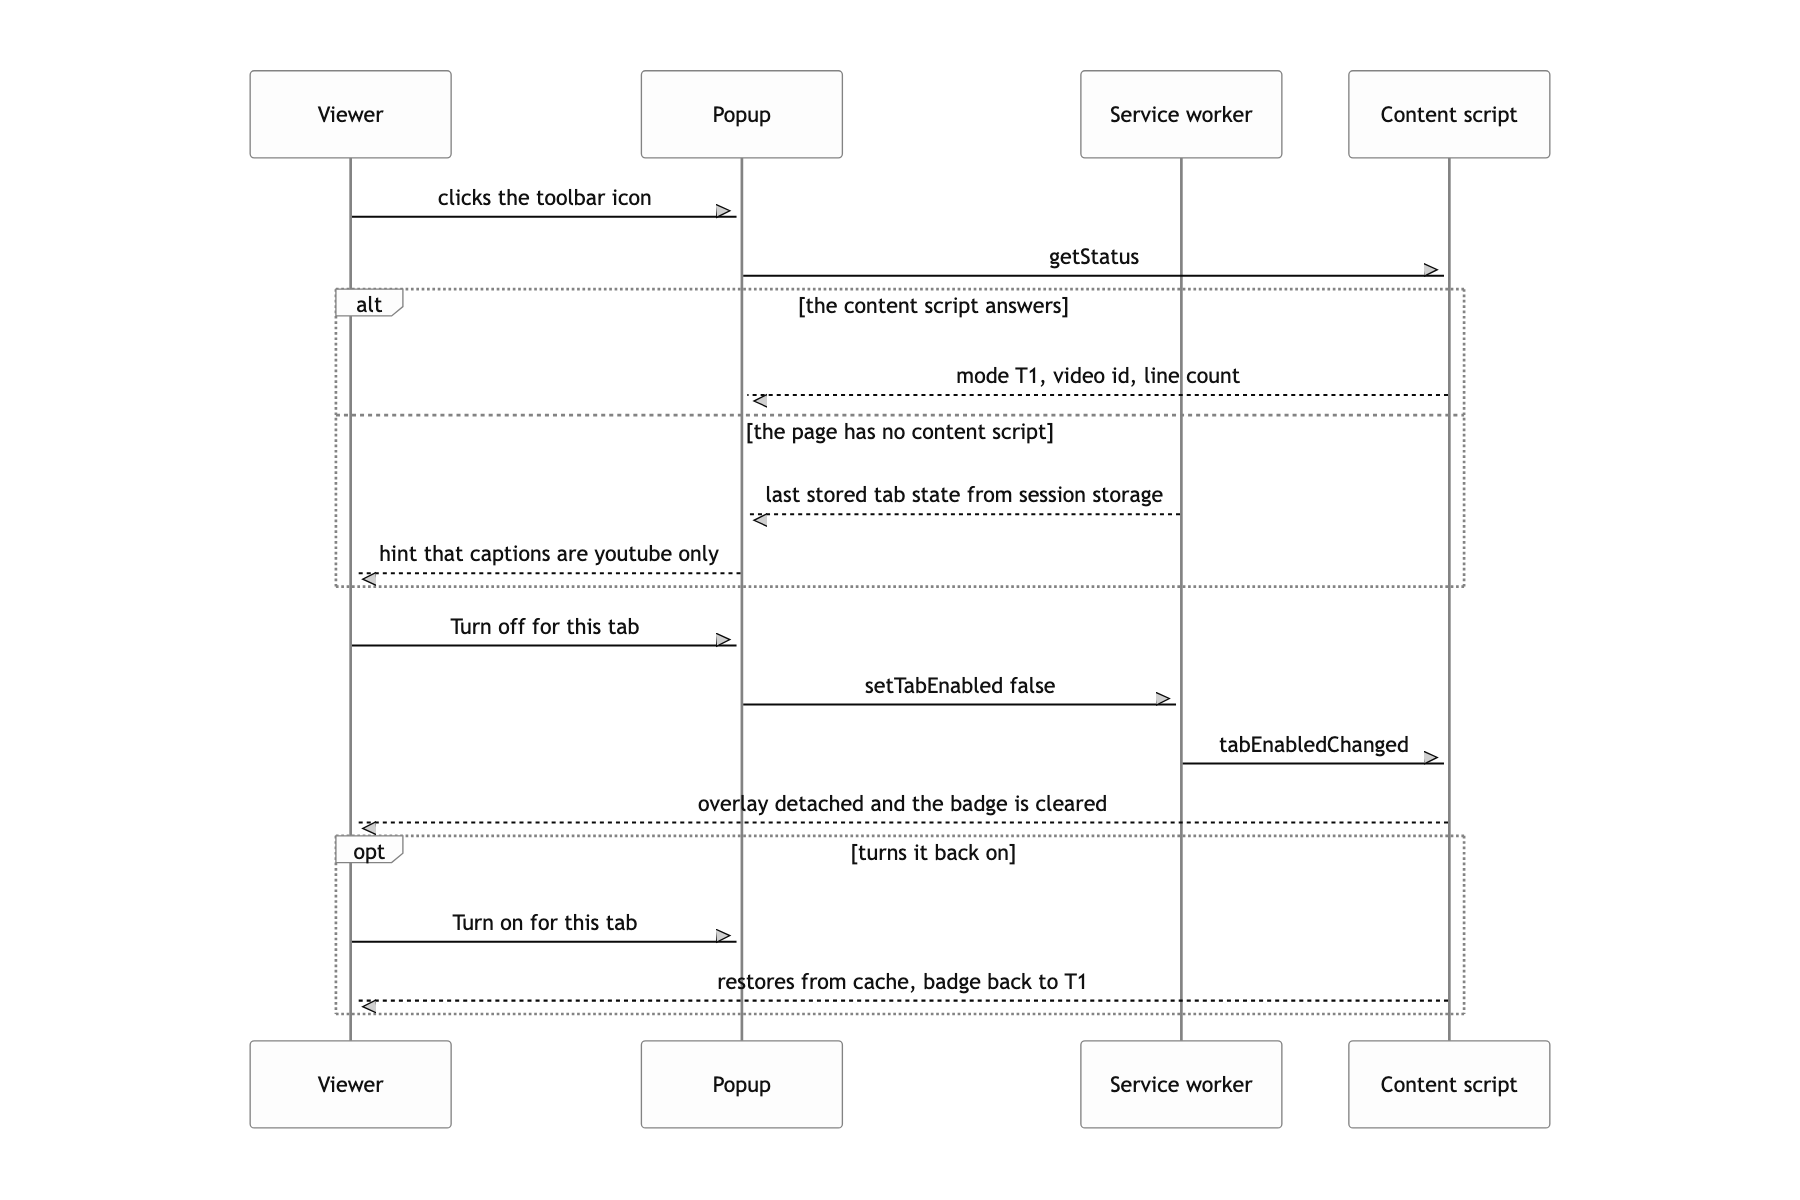
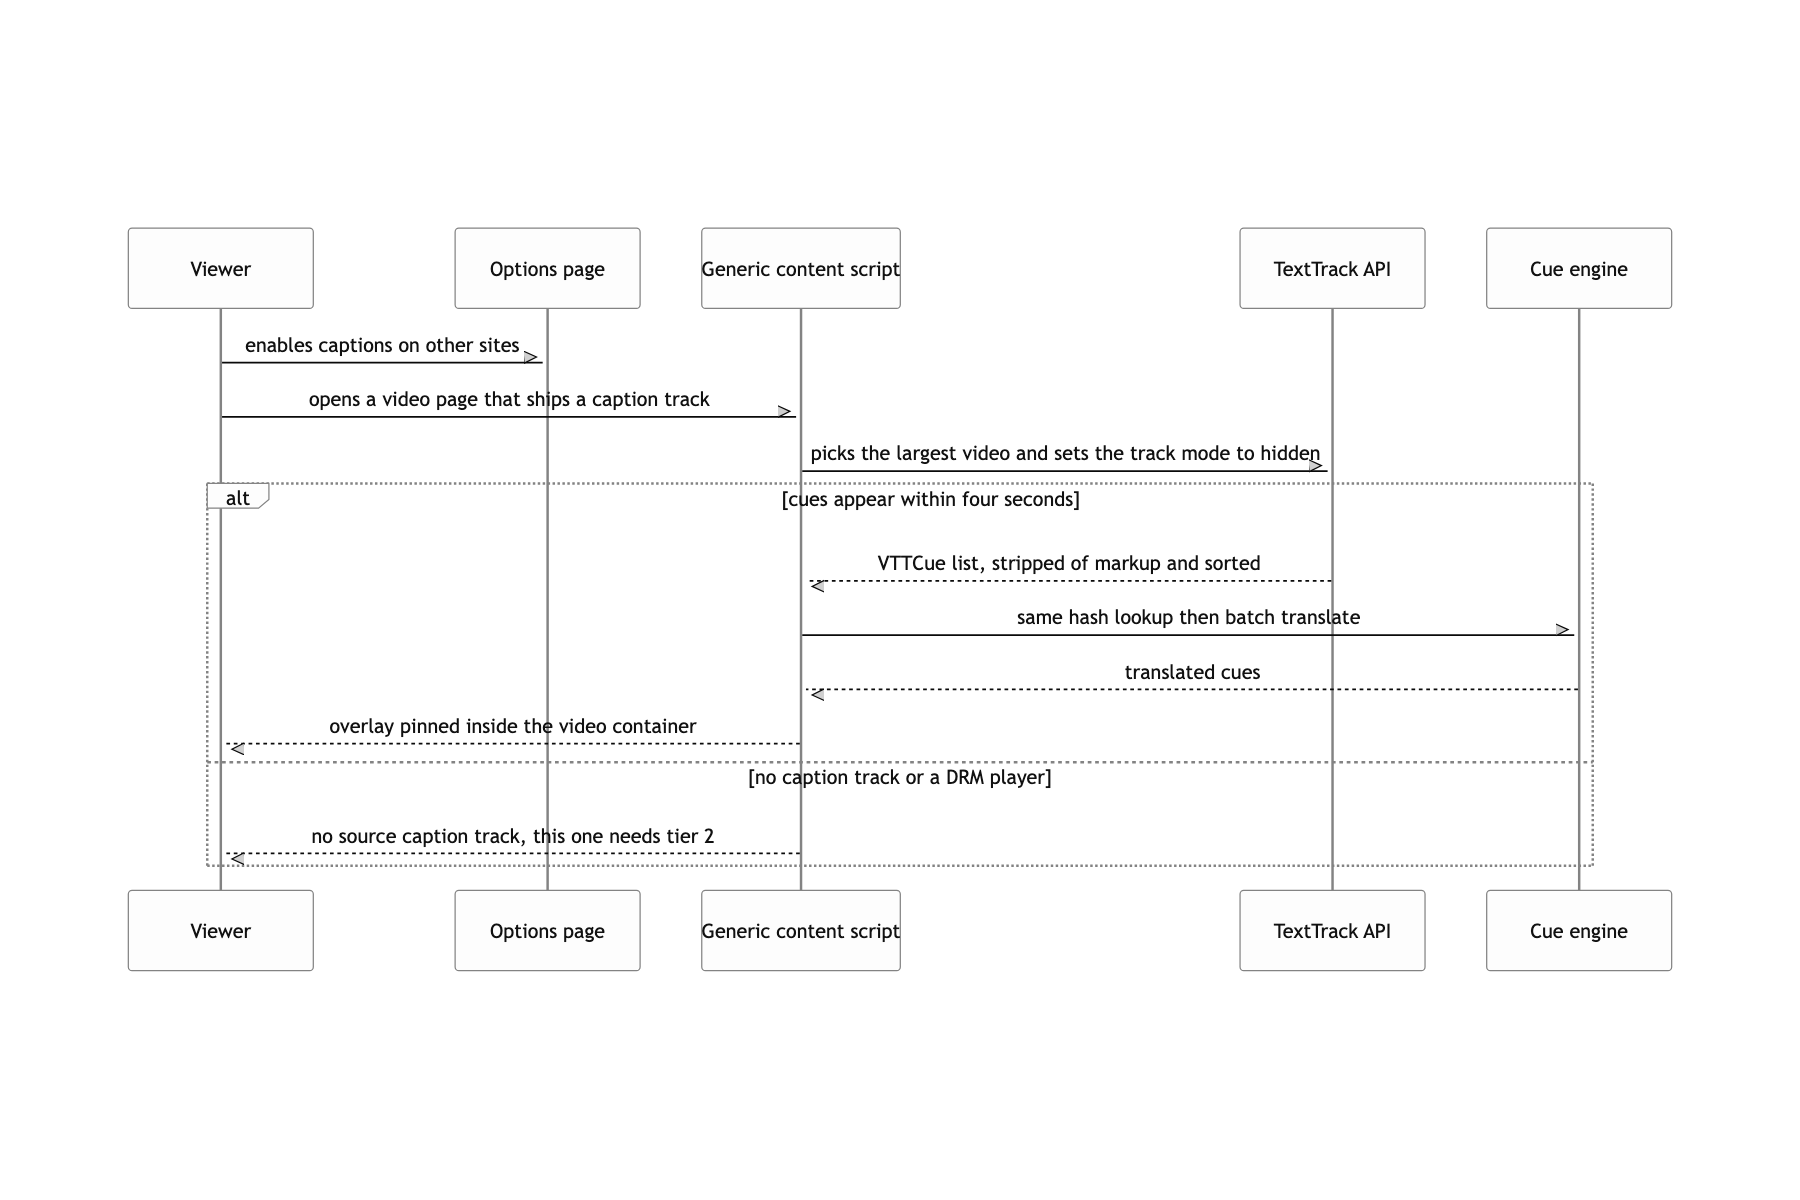
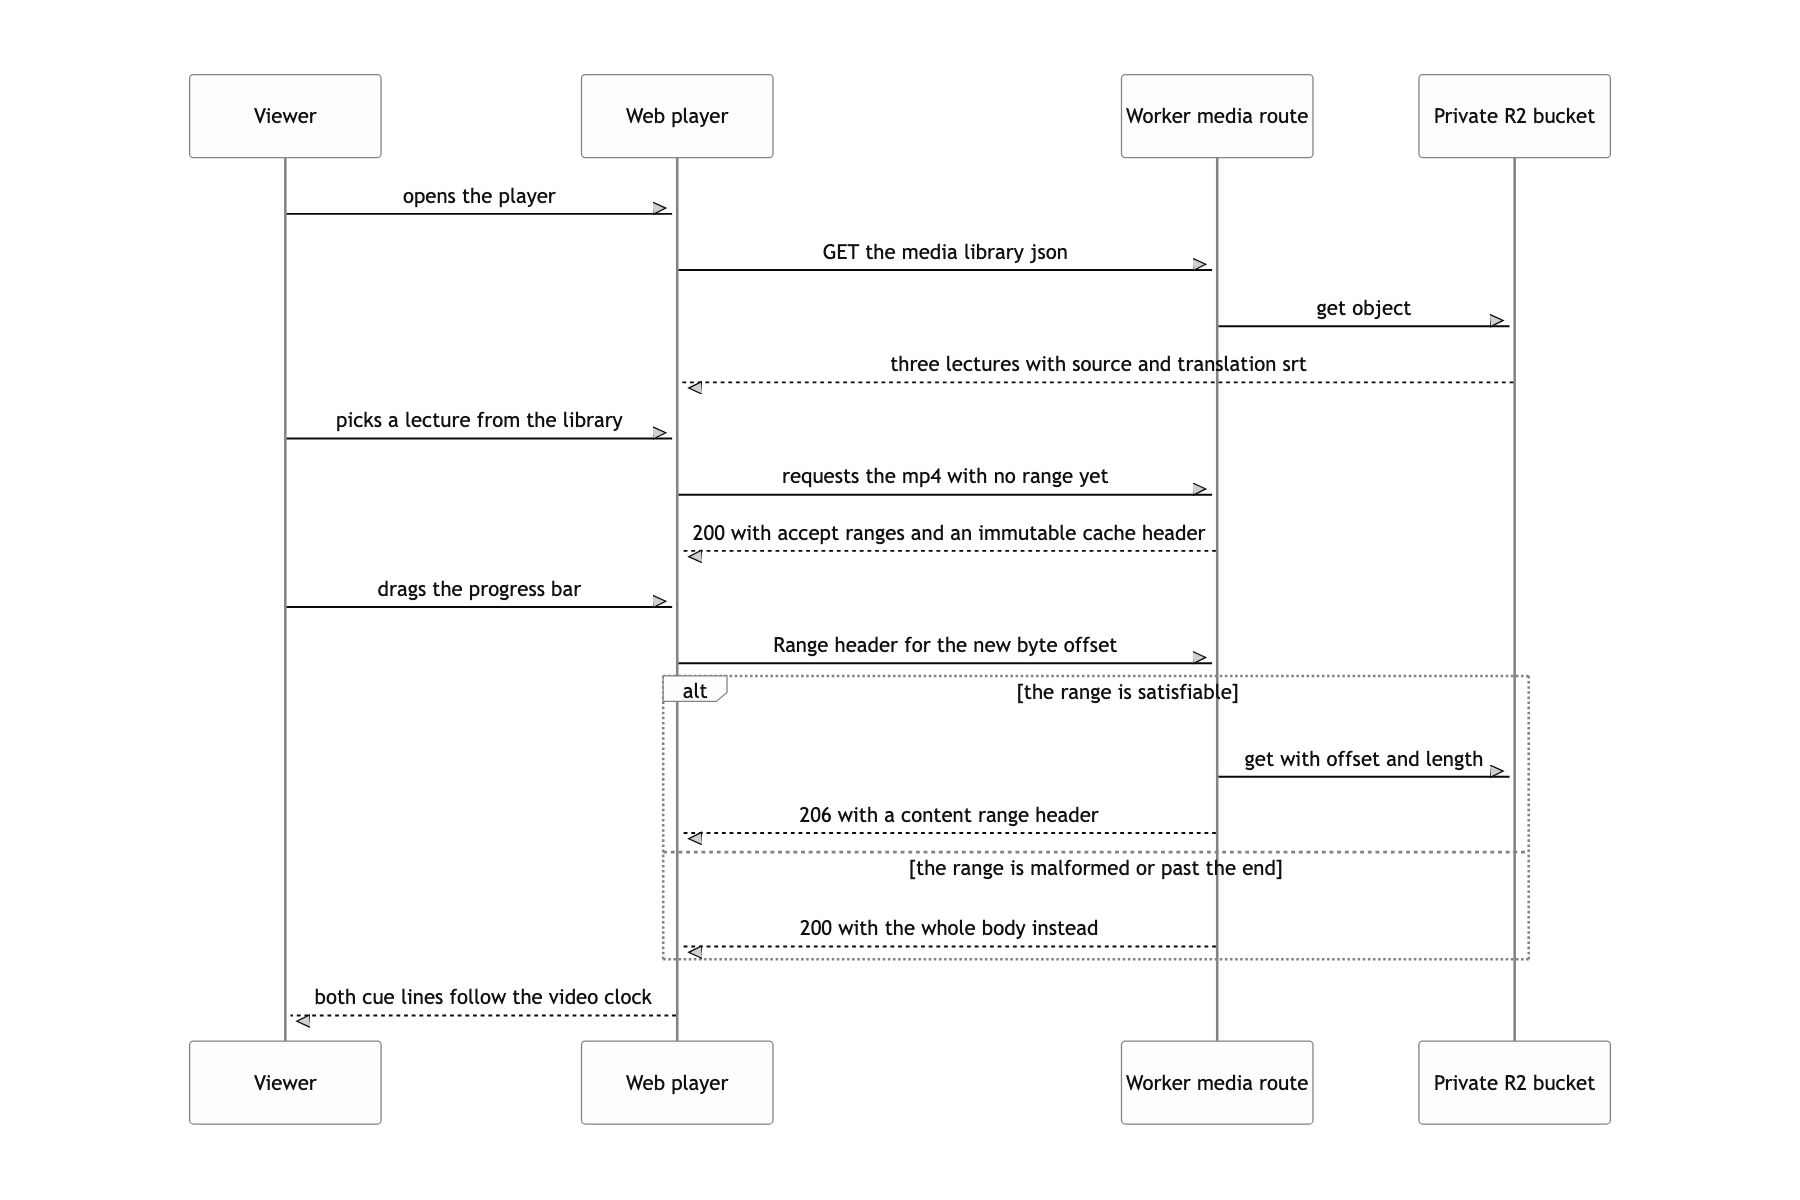
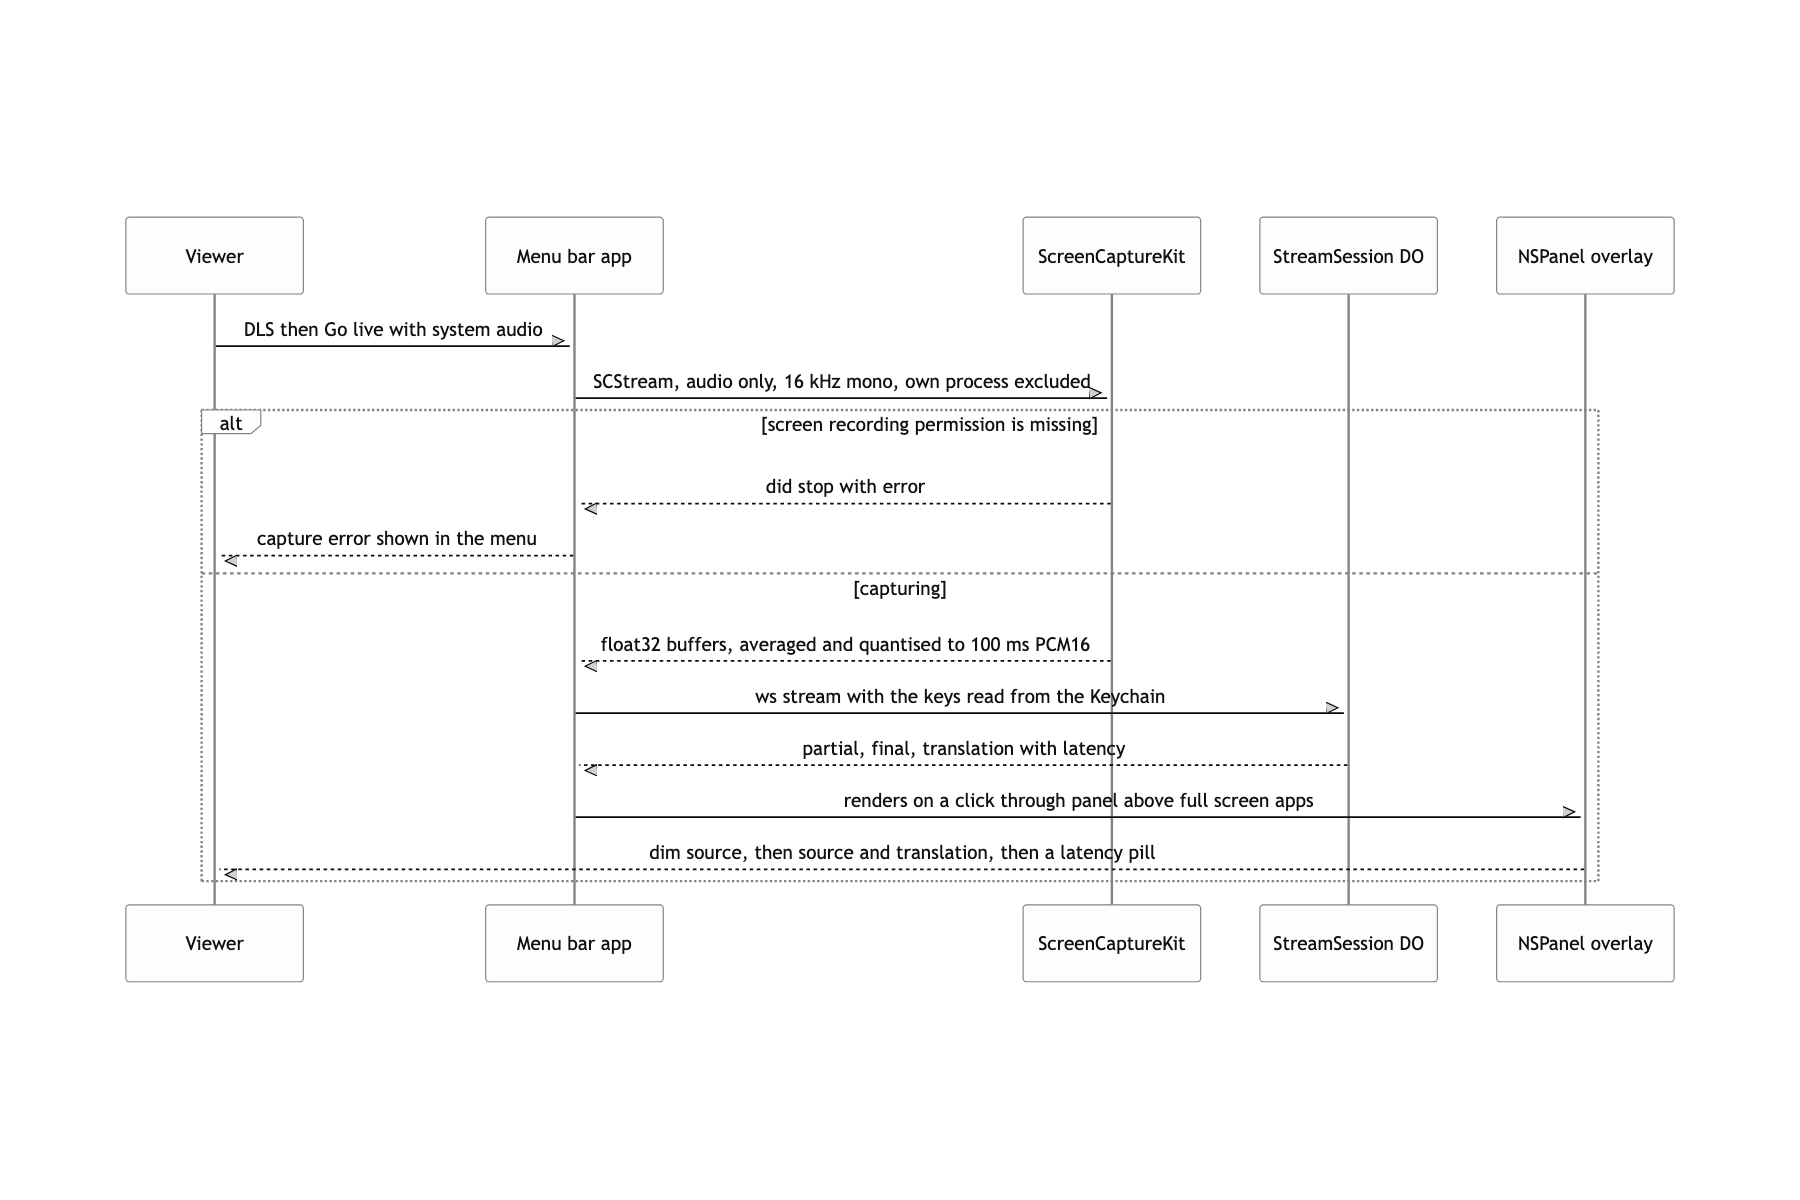
동작은 두 갈래로 갈립니다. 자막 트랙이 있으면(Tier 1) 트랙 전체를 미리 받아 한 번에 번역하고 캐시한 뒤, 재생 중에는 requestAnimationFrame 으로 시각만 맞춥니다. 추가 지연이 0인 이유가 이것이에요. 트랙이 없으면(Tier 2) 오디오가 원본이 됩니다. 확장은 tabCapture 로 잡은 스트림을 오프스크린 문서의 AudioWorklet에서 16 kHz PCM16 100 ms 프레임으로 깎아 보내고, macOS 앱은 ScreenCaptureKit이 준 시스템 오디오를 같은 규격으로 깎아 보냅니다. 받은 쪽 Durable Object는 문장 단위로 끊어 번역하고 지연을 함께 실어 돌려줍니다. 여기서는 이 실시간 경로와 번역 캐시 키 설계만 다룹니다. 비공개 R2 미디어의 Range 서빙과 웹 플레이어의 학습 기능은 각각 따로 다룰 가치가 있는 이야기라 이 글에서는 접습니다.
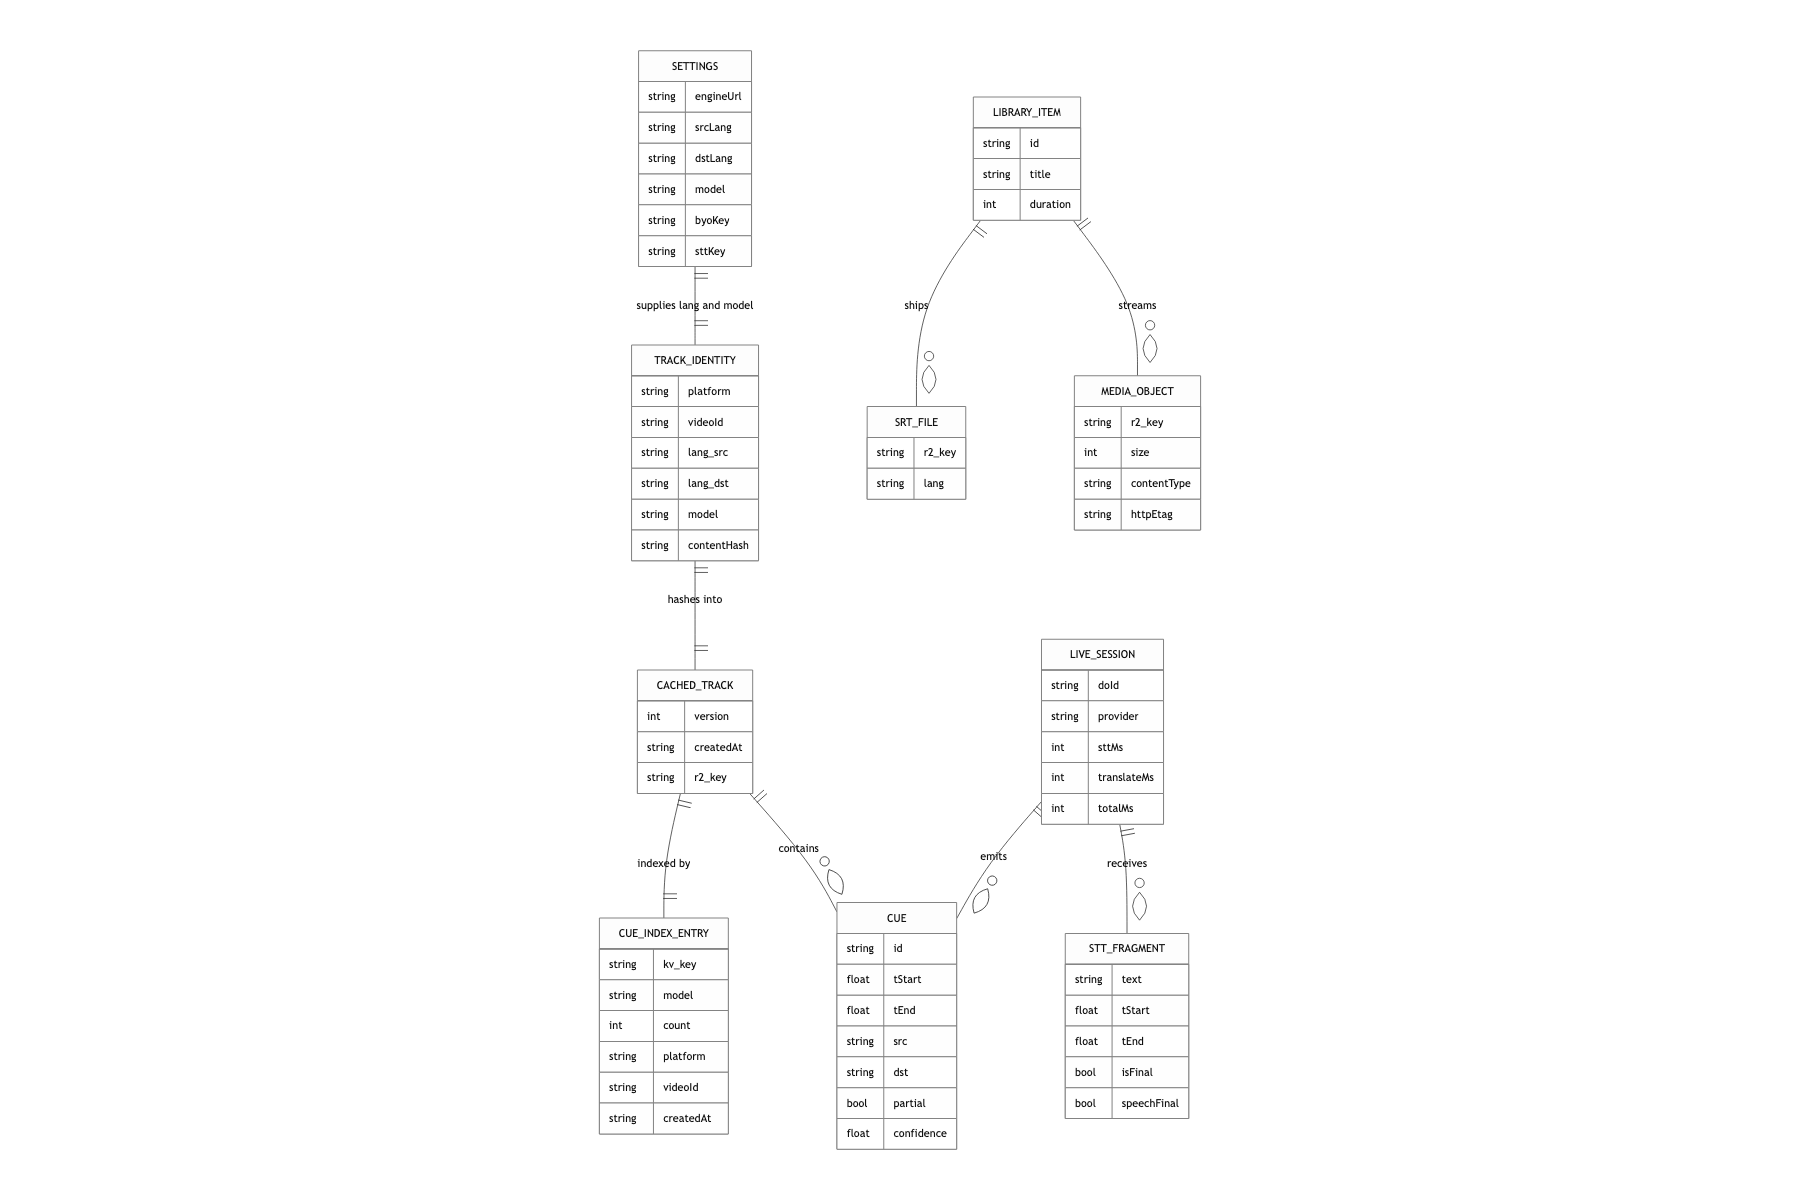
침묵을 기다리지 않고 문장을 확정하기
스트리밍 STT를 처음 붙이면 대개 이렇게 씁니다. 중간 결과(partial)는 버리고, 인식기가 최종이라고 말해 주는 결과(committed)만 모아 문장으로 묶은 다음 번역한다. 문서대로이고 안전해 보이죠. 그런데 Scribe의 커밋 전략은 VAD입니다. 화자가 쉬어야 커밋이 옵니다. 강의나 발표처럼 쉬지 않고 말하는 화면에서는 5초에서 10초치 문장이 한 번에 쏟아지고, 그때까지 화면에는 아무것도 없거나 흐린 중간 텍스트만 떠 있습니다. 자막으로는 쓸 수 없는 물건이 됩니다.
partial 스트림 안에서 이미 확정된 것이나 다름없는 문장을 골라내 먼저 내보냈습니다. completeSentences 는 문장 종결 부호 중에서 뒤에 이미 다음 단어가 붙어 있는 마지막 지점을 찾습니다. 그 앞까지를 잘라 isFinal: true, speechFinal: true 로 즉시 승격시키고, 남은 꼬리만 partial로 보냅니다. 나중에 진짜 committed가 도착하면 이미 내보낸 접두사(emittedPrefix)를 잘라 낸 나머지만 흘려보내 중복을 막습니다. 그 위에 문장 분할기가 네 가지 조건(종결 부호, 침묵 0.6초, 80자, 시작 후 1.5초)으로 다시 한 번 끊고, 조건 4에 필요한 시계는 DO가 250 ms setInterval 로 마지막 프래그먼트 시각을 외삽해 넣어 줍니다.
partial은 문장 중간에서는 계속 흔들리지만, 어떤 문장 뒤에 다음 단어가 이미 붙었다면 그 문장은 인식기가 더 손댈 이유가 없습니다. 이 관찰 하나로 VAD의 침묵을 기다리는 시간을 통째로 날릴 수 있어요. 문장 단위로 끊는 것도 취향이 아니라 필요입니다. 영어를 일본어나 한국어로 옮기면 어순이 뒤집히므로, 조각으로 번역하면 말이 되지 않거든요. 실제 ElevenLabs와 OpenRouter를 물린 20초 스트리밍 측정에서 문장 확정부터 번역 표시까지 p50 1101 ms, p95 1132 ms가 나왔습니다.
캐시 키를 내용의 지문으로 만들고, 서버가 그걸 다시 계산해 검증한다
번역 캐시를 처음 만들면 키를 cues/<videoId> 나 <videoId>-en-ko 로 잡게 됩니다.
키를 신원과 내용의 해시로 정의했습니다. hash = sha256(platform, videoId, srcLang, dstLang, model, contentHash) 이고, contentHash 는 원문 큐의 개수 + 시작시각과 원문을 이어 붙인 텍스트 를 다시 해시한 값입니다.
키가 곧 내용의 지문이라서, 어떤 클라이언트도 자기가 실제로 들고 있는 자막에 대응하는 키 말고는 계산해 낼 수 없습니다.
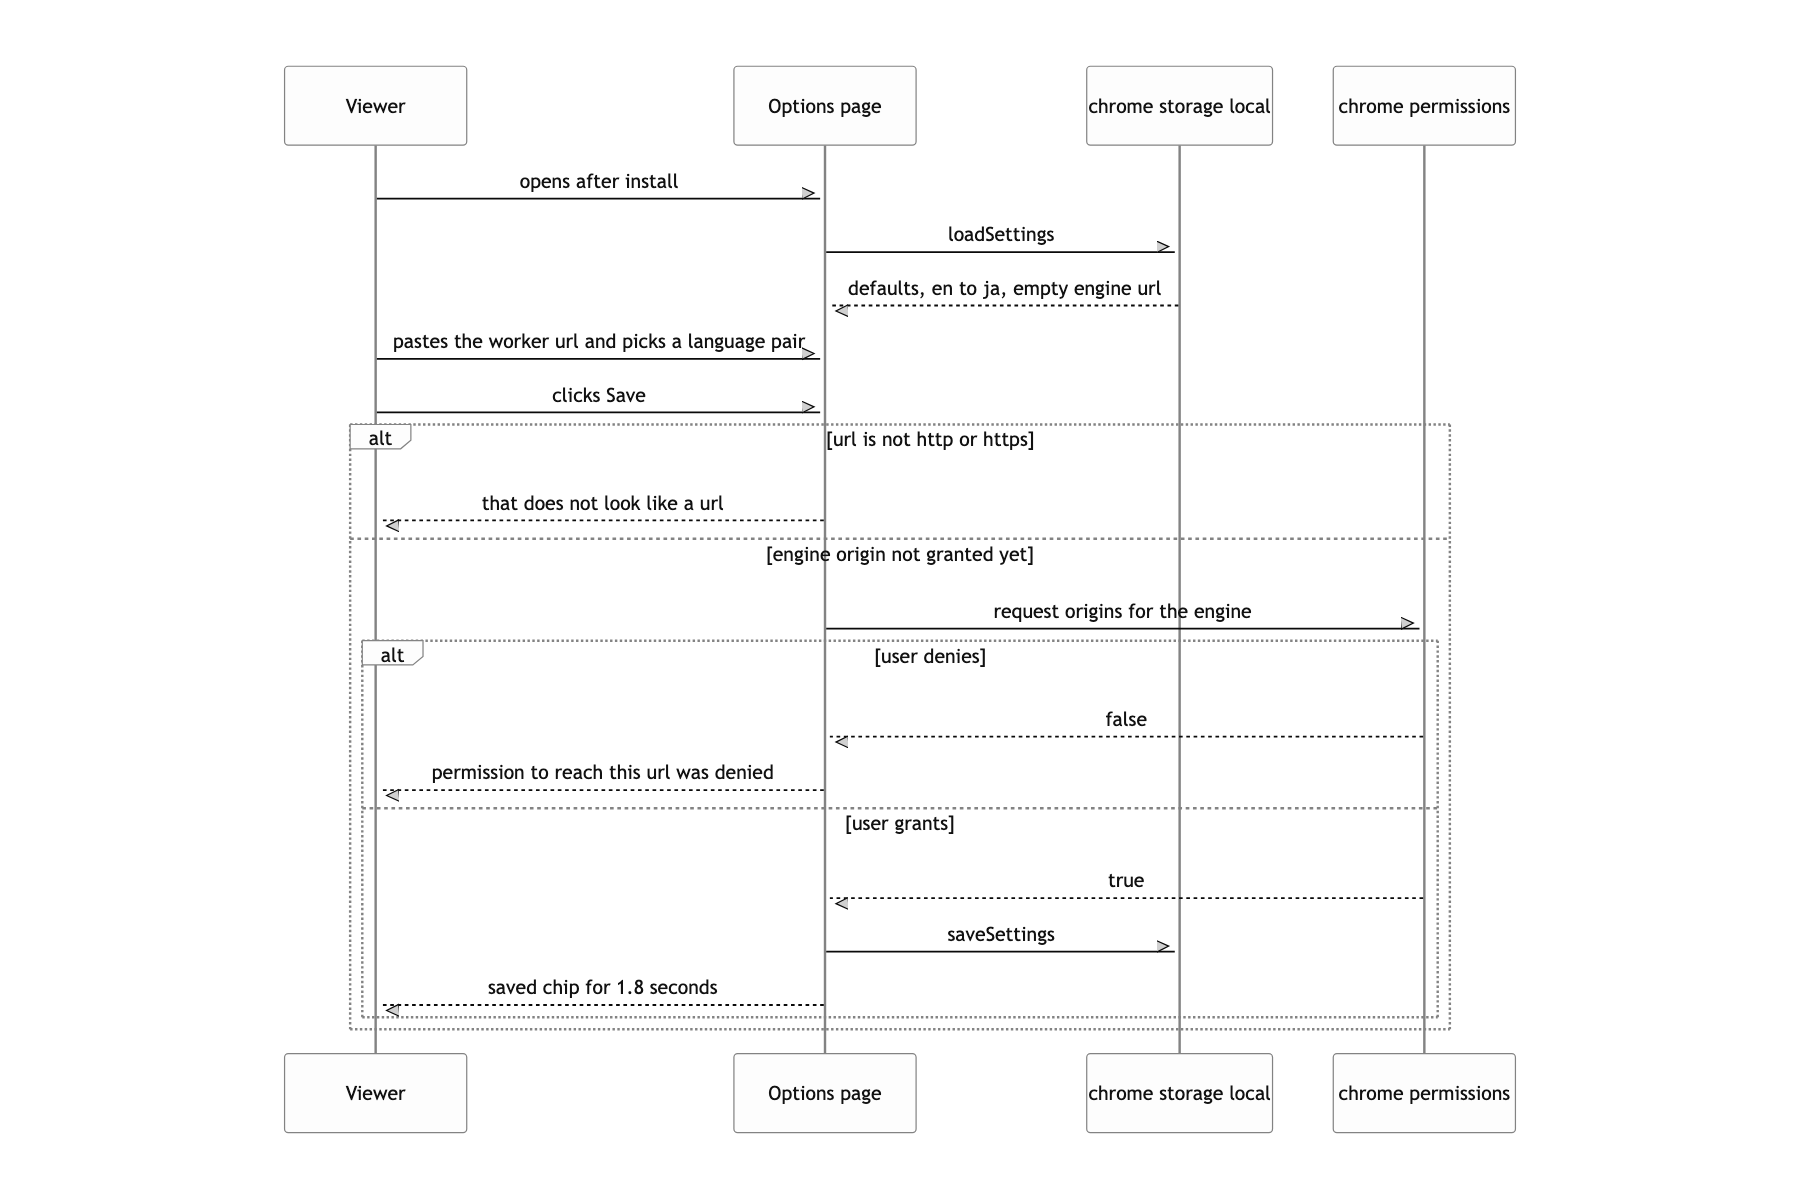
유저가 할 수 있는 일
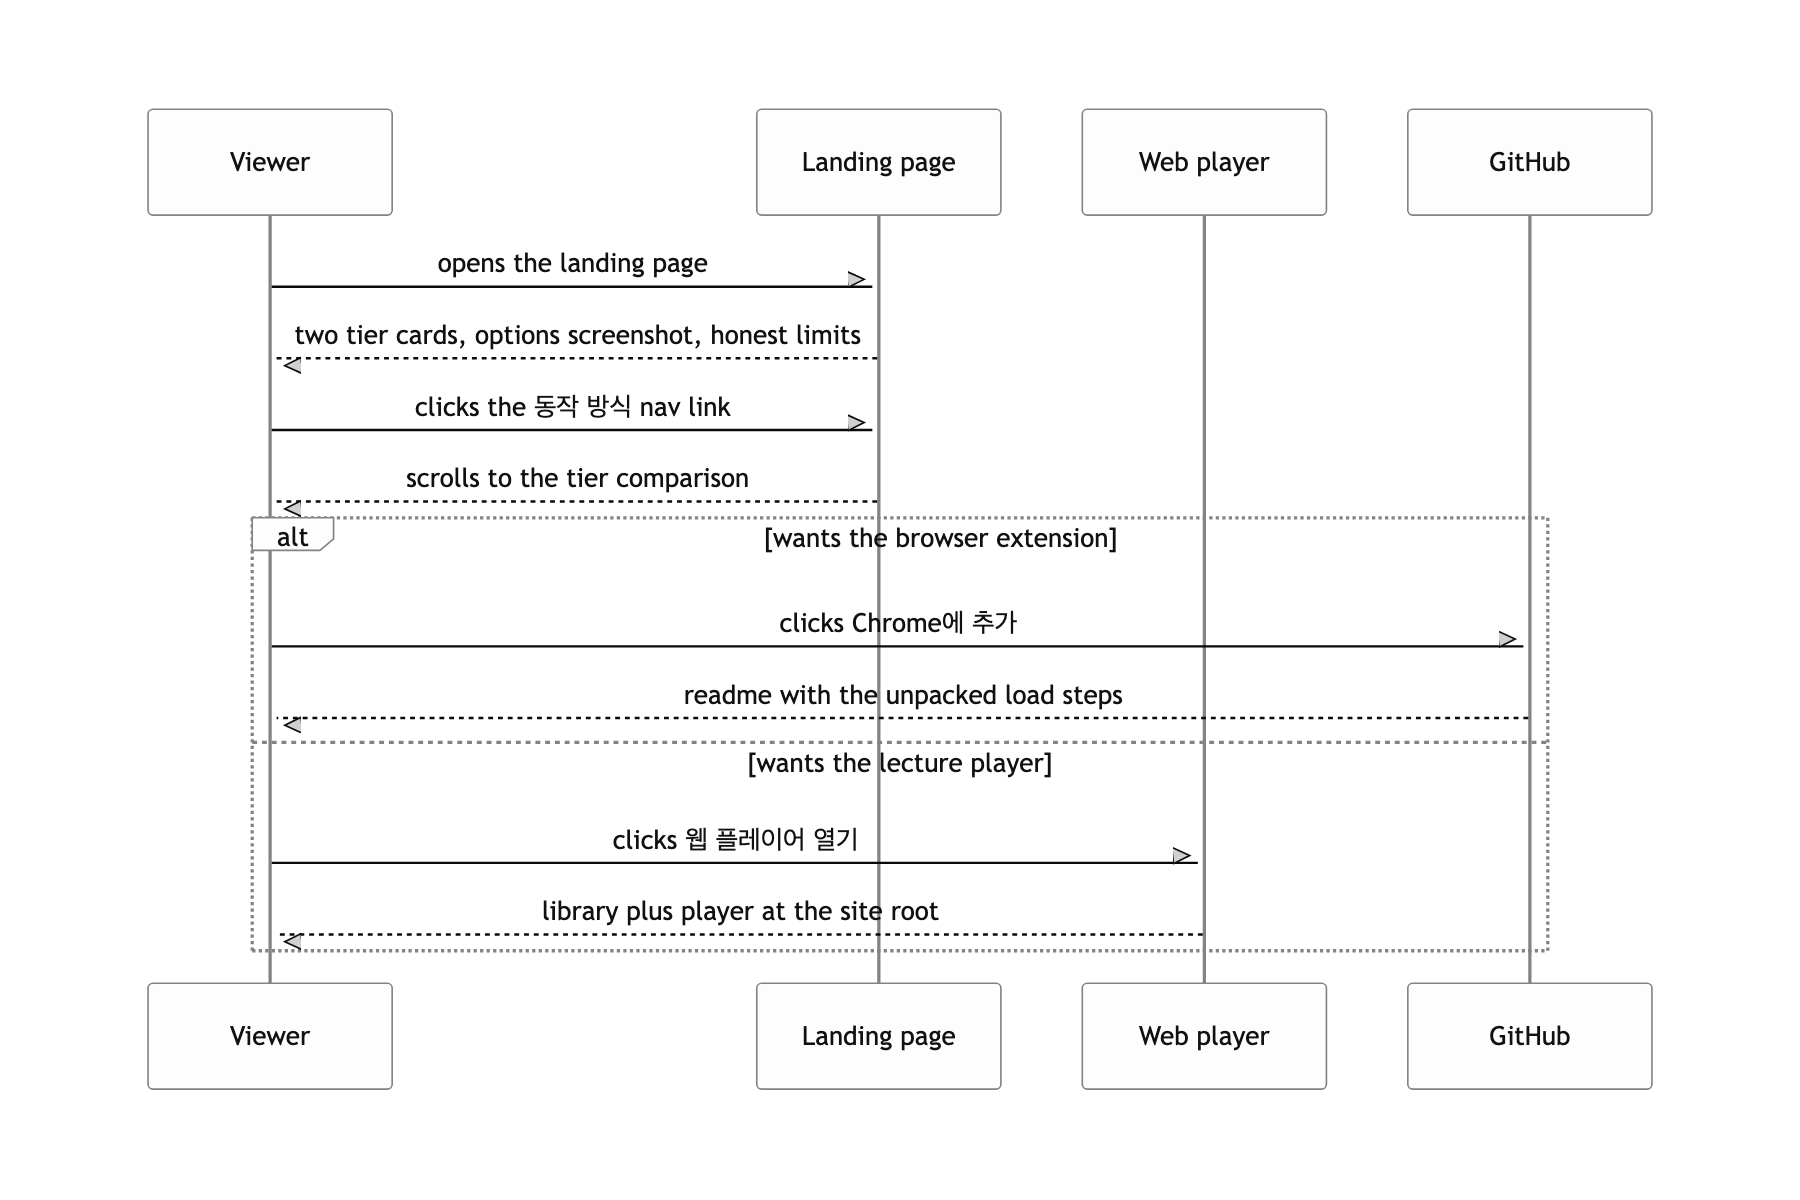
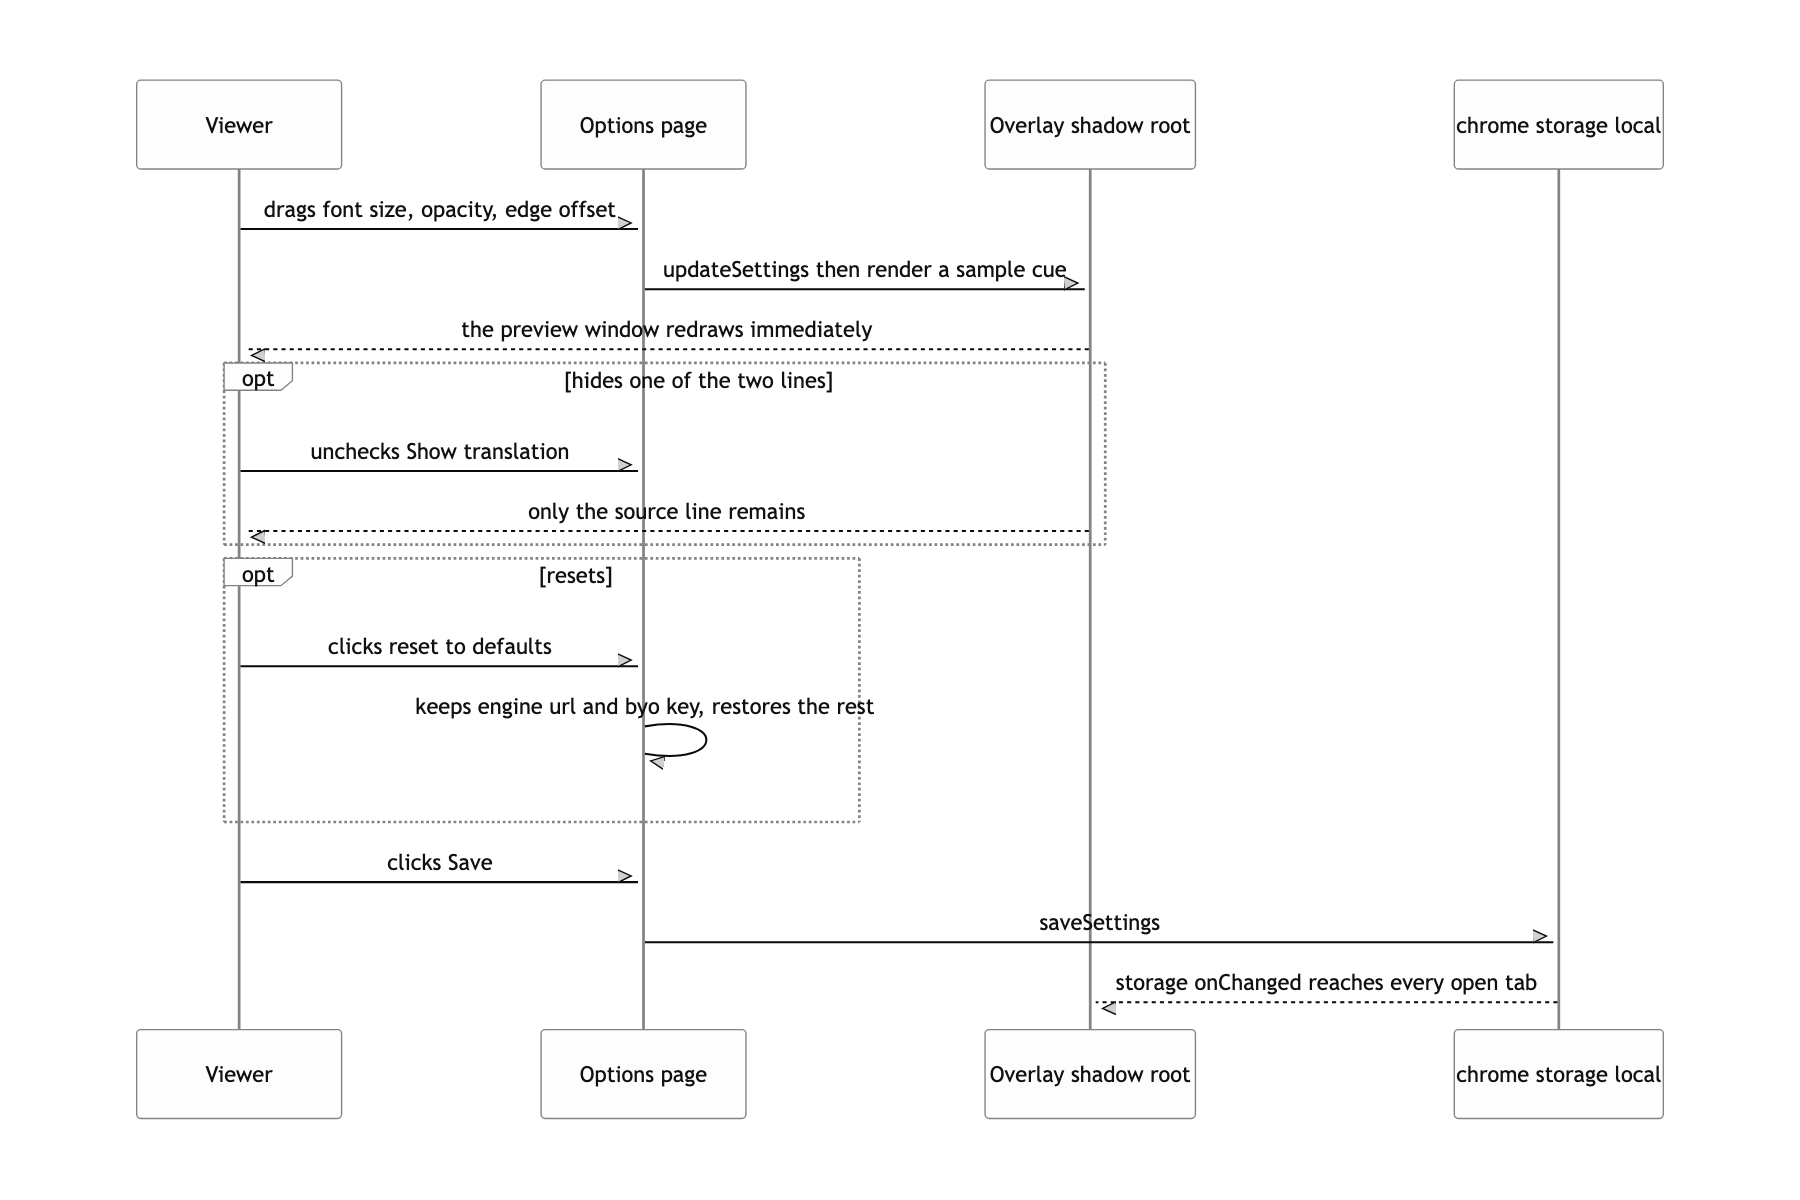
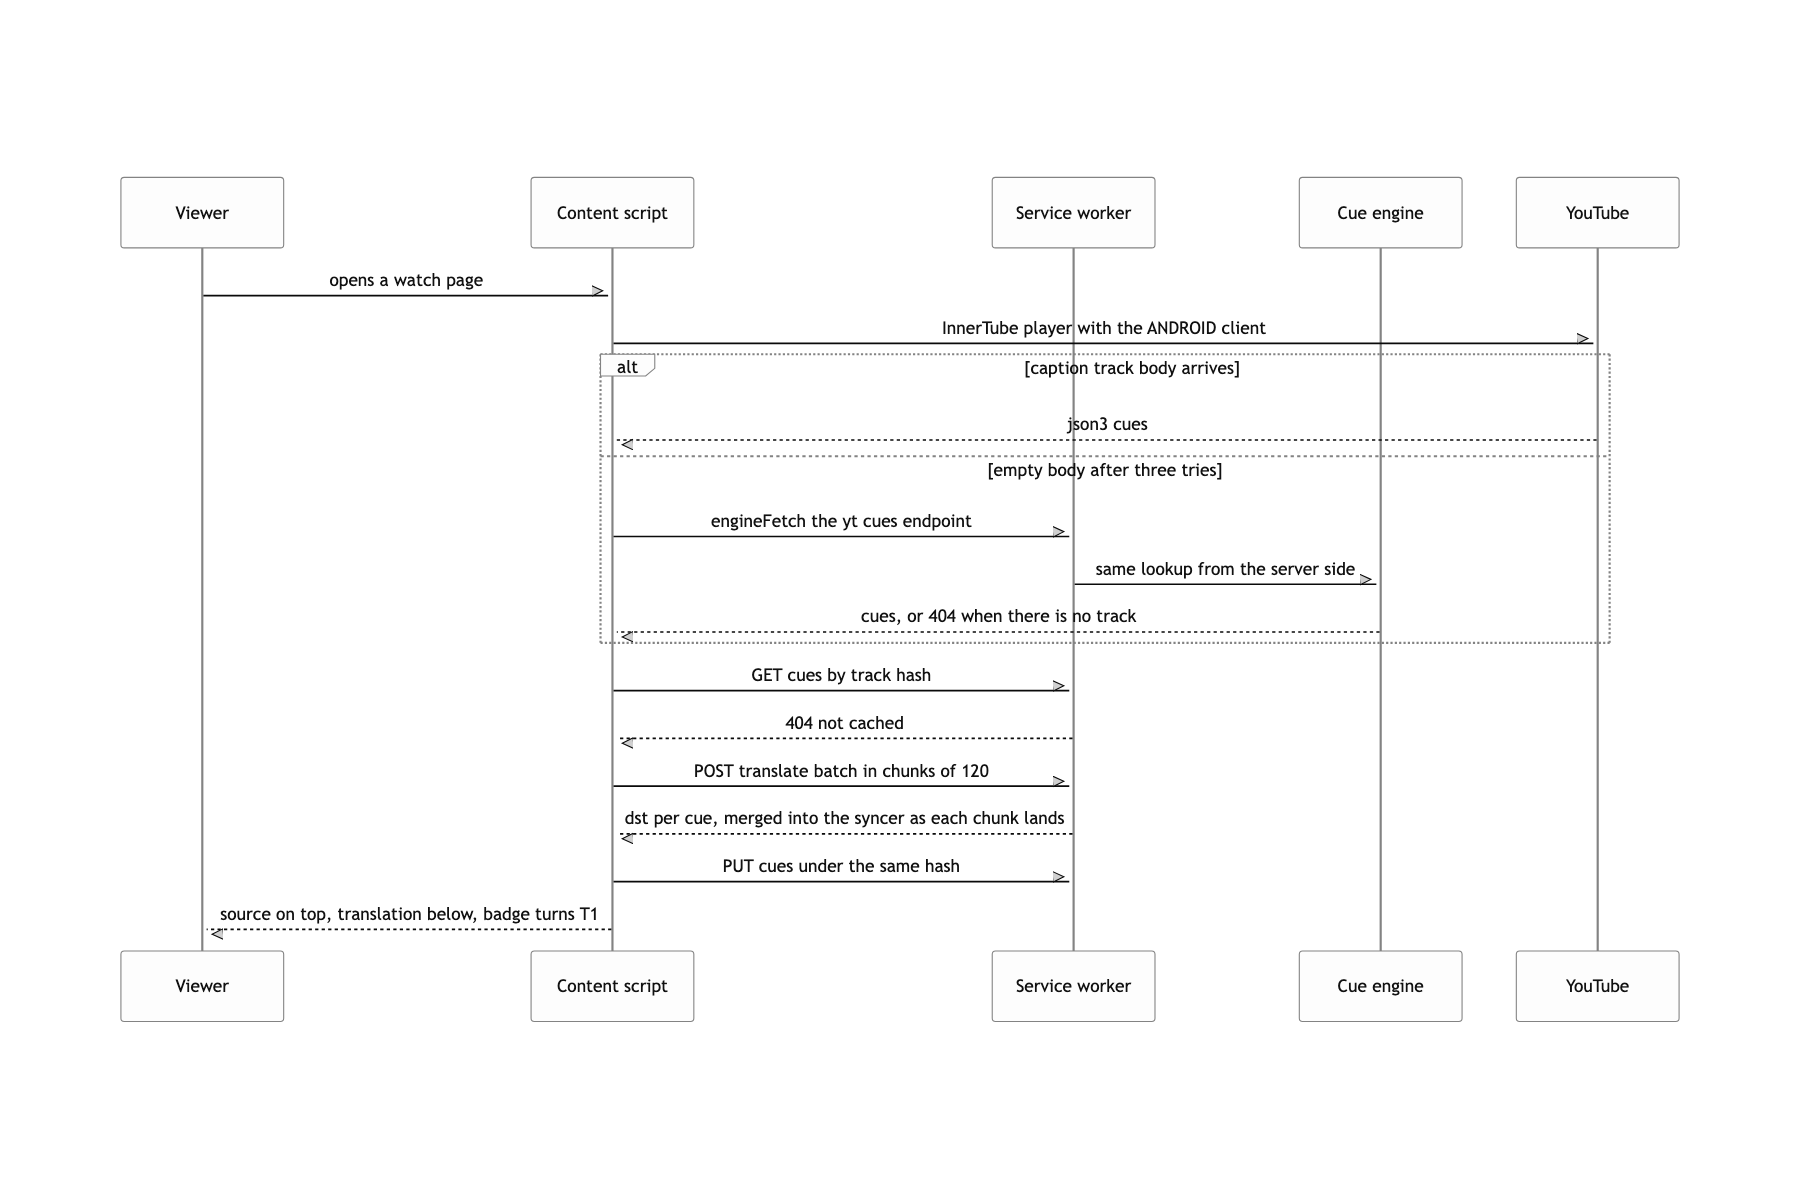
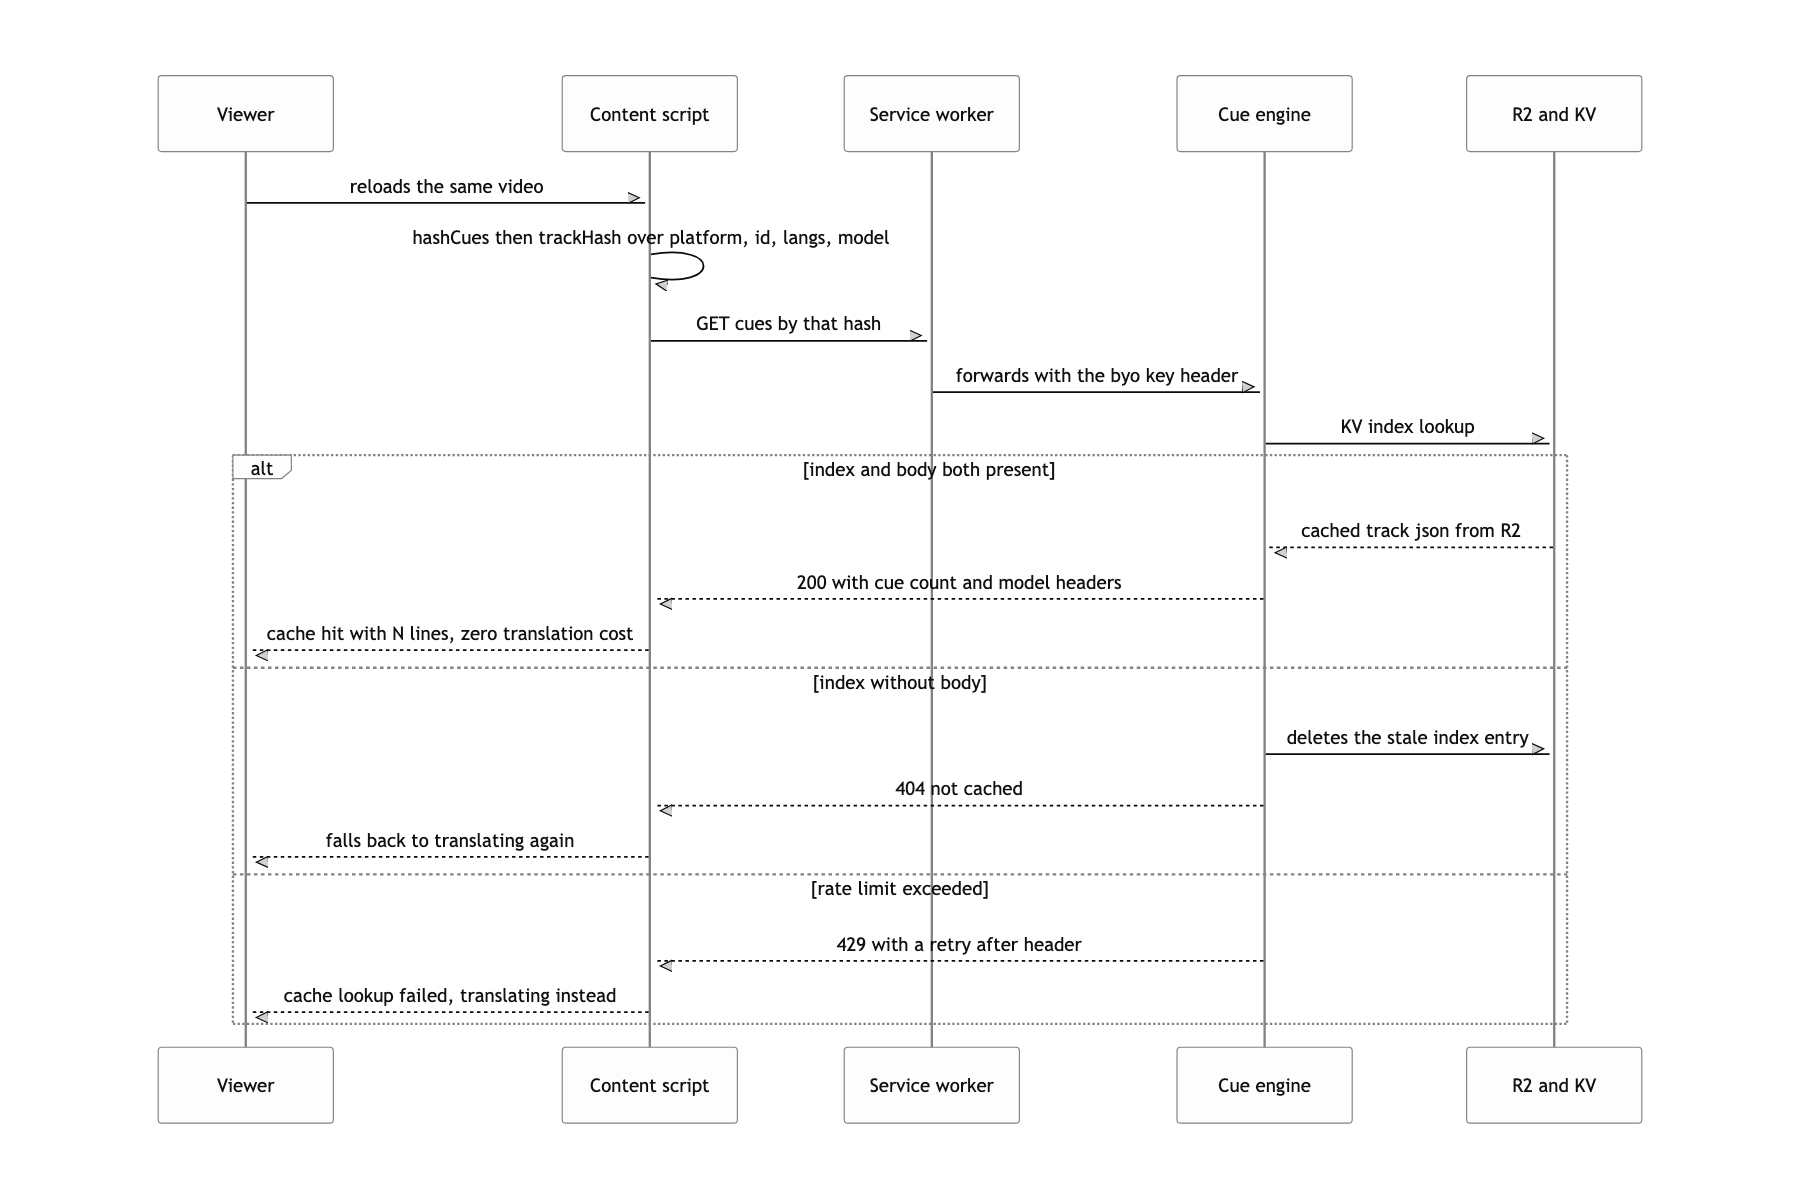
무른 레이트 리밋과 미뤄 둔 계약 테스트
레이트 리밋을 KV 고정 윈도로 짰습니다. KV는 최종적 일관성이라 이건 정확한 쿼터가 아니라 폭주하는 클라이언트를 막는 무른 상한이에요. 코드 주석에도 그렇게 적어 뒀습니다. 다시 만든다면 Cloudflare의 Rate Limiting 바인딩이나 IP 해시로 나눈 Durable Object로 옮기겠습니다.
실시간 자막은 벽시계에 붙어 있습니다. 영상 타임라인이 아니라 도착한 순간에 그려지기 때문에, 되감으면 자막이 따라오지 않습니다. Tier 1과 Tier 2의 렌더링 모델이 근본적으로 다른 건데, 이걸 하나로 합치려면 라이브 세션도 큐를 미디어 시각에 앵커링해서 저장해야 합니다. 지금은 저장하지 않기로 한 결정(오디오도 전사도 남기지 않음)과 정면으로 부딪혀서 미뤘어요.
YouTube 자막 취득 경로가 4단 폴백입니다. InnerTube ANDROID 클라이언트, 엔진 경유, 워치 페이지 직접 fetch, 그리고 플레이어 응답 가로채기. 지금은 1단에서 거의 다 끝나지만 이건 어디까지나 2026년 8월에 검증한 사실이고, 언제든 막힐 수 있습니다. 각 경로에 대한 계약 테스트가 한 줄도 없어서 하나가 조용히 죽어도 폴백이 덮어 버립니다. 최소한 각 경로를 개별로 때려 보는 스모크 테스트는 있어야 했습니다.
